最近、プログラミング言語PHPの脆弱性が話題となりました。
PHPを利用して基幹システムを構築している企業の中には、システムを開発した技術者の離職や、システムの仕様が十分にドキュメント化されていないことなどによって、脆弱性への対応が困難になっている企業もあります。
このような問題を背景に、既存システムの維持・改修を続けるのではなく、この機会に基幹システムを最新の技術で再構築(モダナイズ)するという選択をする企業もあるようです。
そこで今回は、AIエージェントの活用に適したデータ基盤である「自律分散型データ基盤」について、次の5つの観点から説明します。
自律分散型データ基盤は、既存の基幹システムをモダナイズするとともに、AIエージェントを活用した業務の自律化を実現するための選択肢の一つです。
基幹システムの再構築を検討されている企業の皆様にとって、参考になれば幸いです。
AIエージェントドリブン経営の仕組
AIエージェントドリブン経営を実現する基盤は、次の3つの要素から構成されます。
- AIエージェントドリブン経営プラットホーム
企業のメンバーやAIエージェントがマネジメントサイクルのタスクを遂行する時の実行基盤。 - ナレッジベース
企業のメンバーやAIエージェントがマネジメントサイクルのタスクを遂行する時の判断基準になる規範ナレッジや戦略ナレッジ、および、タスクを遂行した結果記録される実践ナレッジを管理する基盤。 - 自律分散型データ基盤
会社のデータを中央のデータウェアハウスなどの管理基盤で一元的に集約・管理する集中型のデータ基盤ではなく、
データと、それを扱う業務機能をマイクロサービス単位でカプセル化し、疎結合で連携させる分散型のデータ基盤。
AIエージェントは、ナレッジベースに定義されたAPIを介して、自律分散型データ基盤のマイクロサービスにアクセスし業務データを取得、更新します。
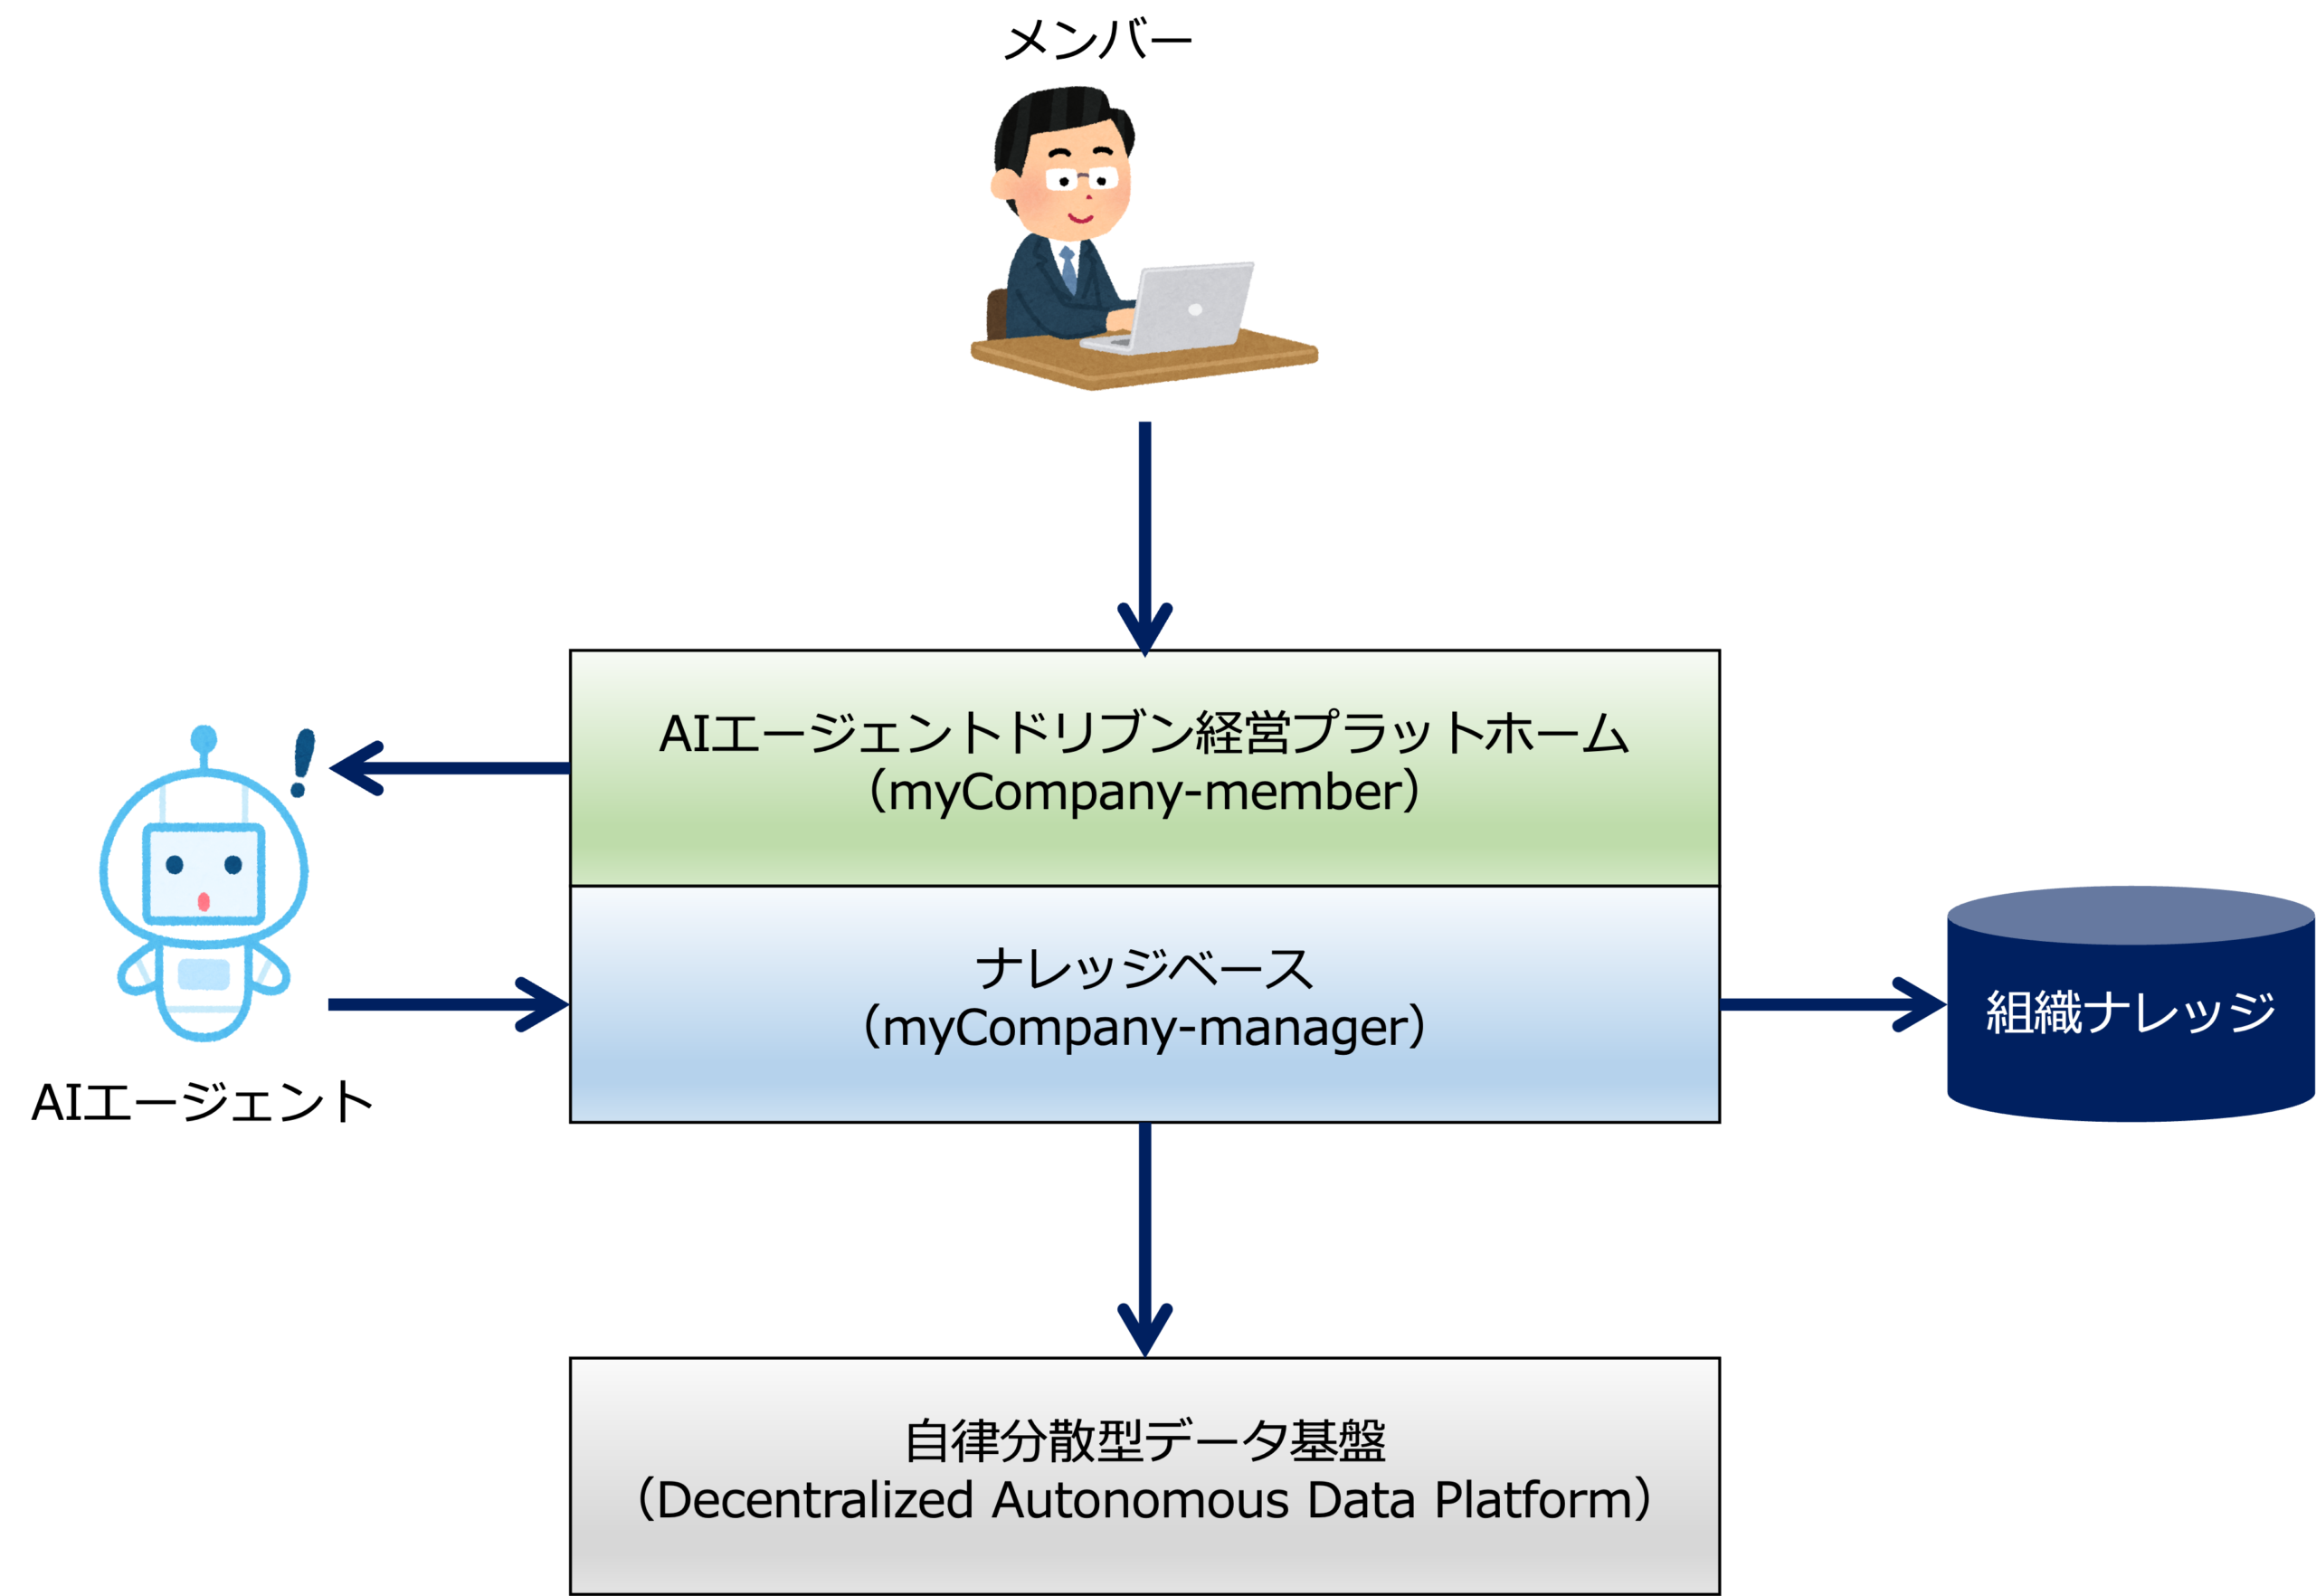
ここでは、このうち「自律分散型データ基盤」について説明します。
まず、その構造から見ていきましょう。
自律分散型データ基盤の構造
自律分散型データ基盤とは、会社の業務機能をマイクロサービス単位でカプセル化し、疎結合で連携させる分散型のデータ基盤です。
次の図は、会社の業務機能を担うマイクロサービス同士がデータ連携基盤を介して結合している自律分散型データ基盤の構造を表したものです。
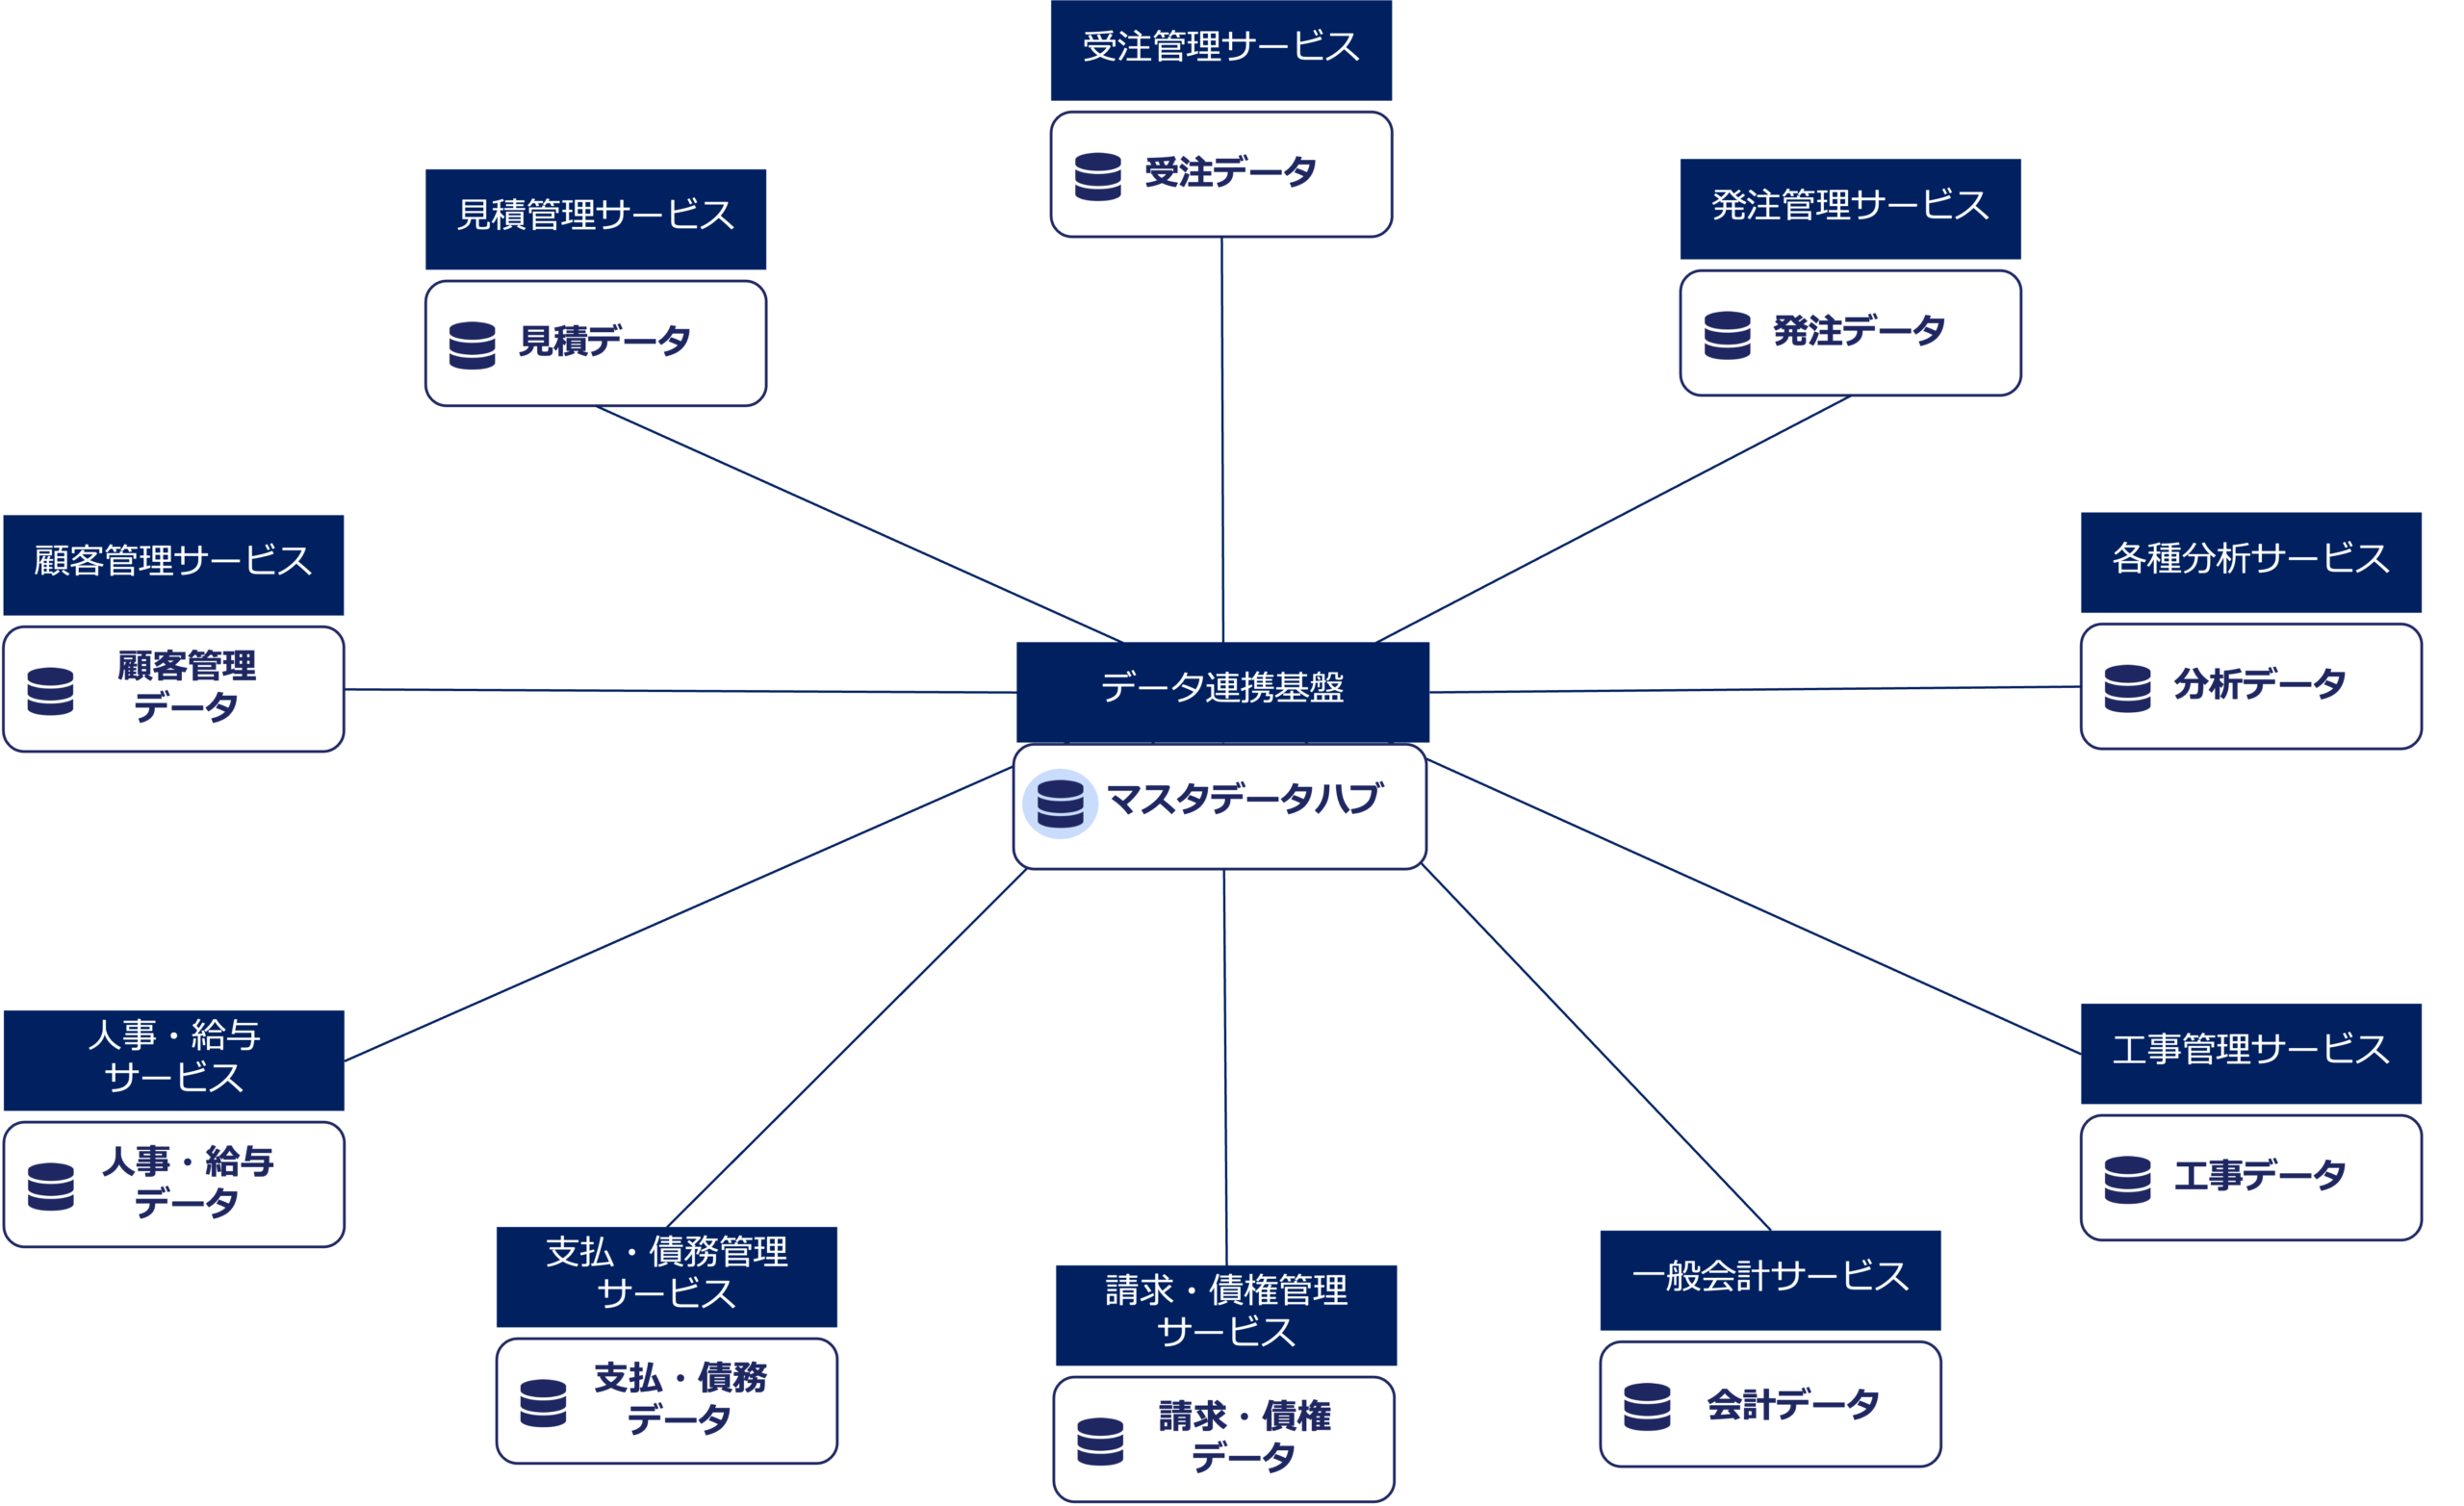
データ連携基盤とは、社内外や自治体などの分散したシステム・サービスをつなぎ、データの収集・変換・配信を一元的に行う仕組みで、最近では、クラウド上で本機能を提供する iPaaS (Integration Platform as a Service) があります。
上図の中央にあるマスタデータハブとは、企業のマスタデータを中央で一元管理し各マイクロサービスに提供する機能です。
マスタデータハブは、顧客マスタ管理サービスなど各マスタデータを管理するマイクロサービス群によって構成されています。
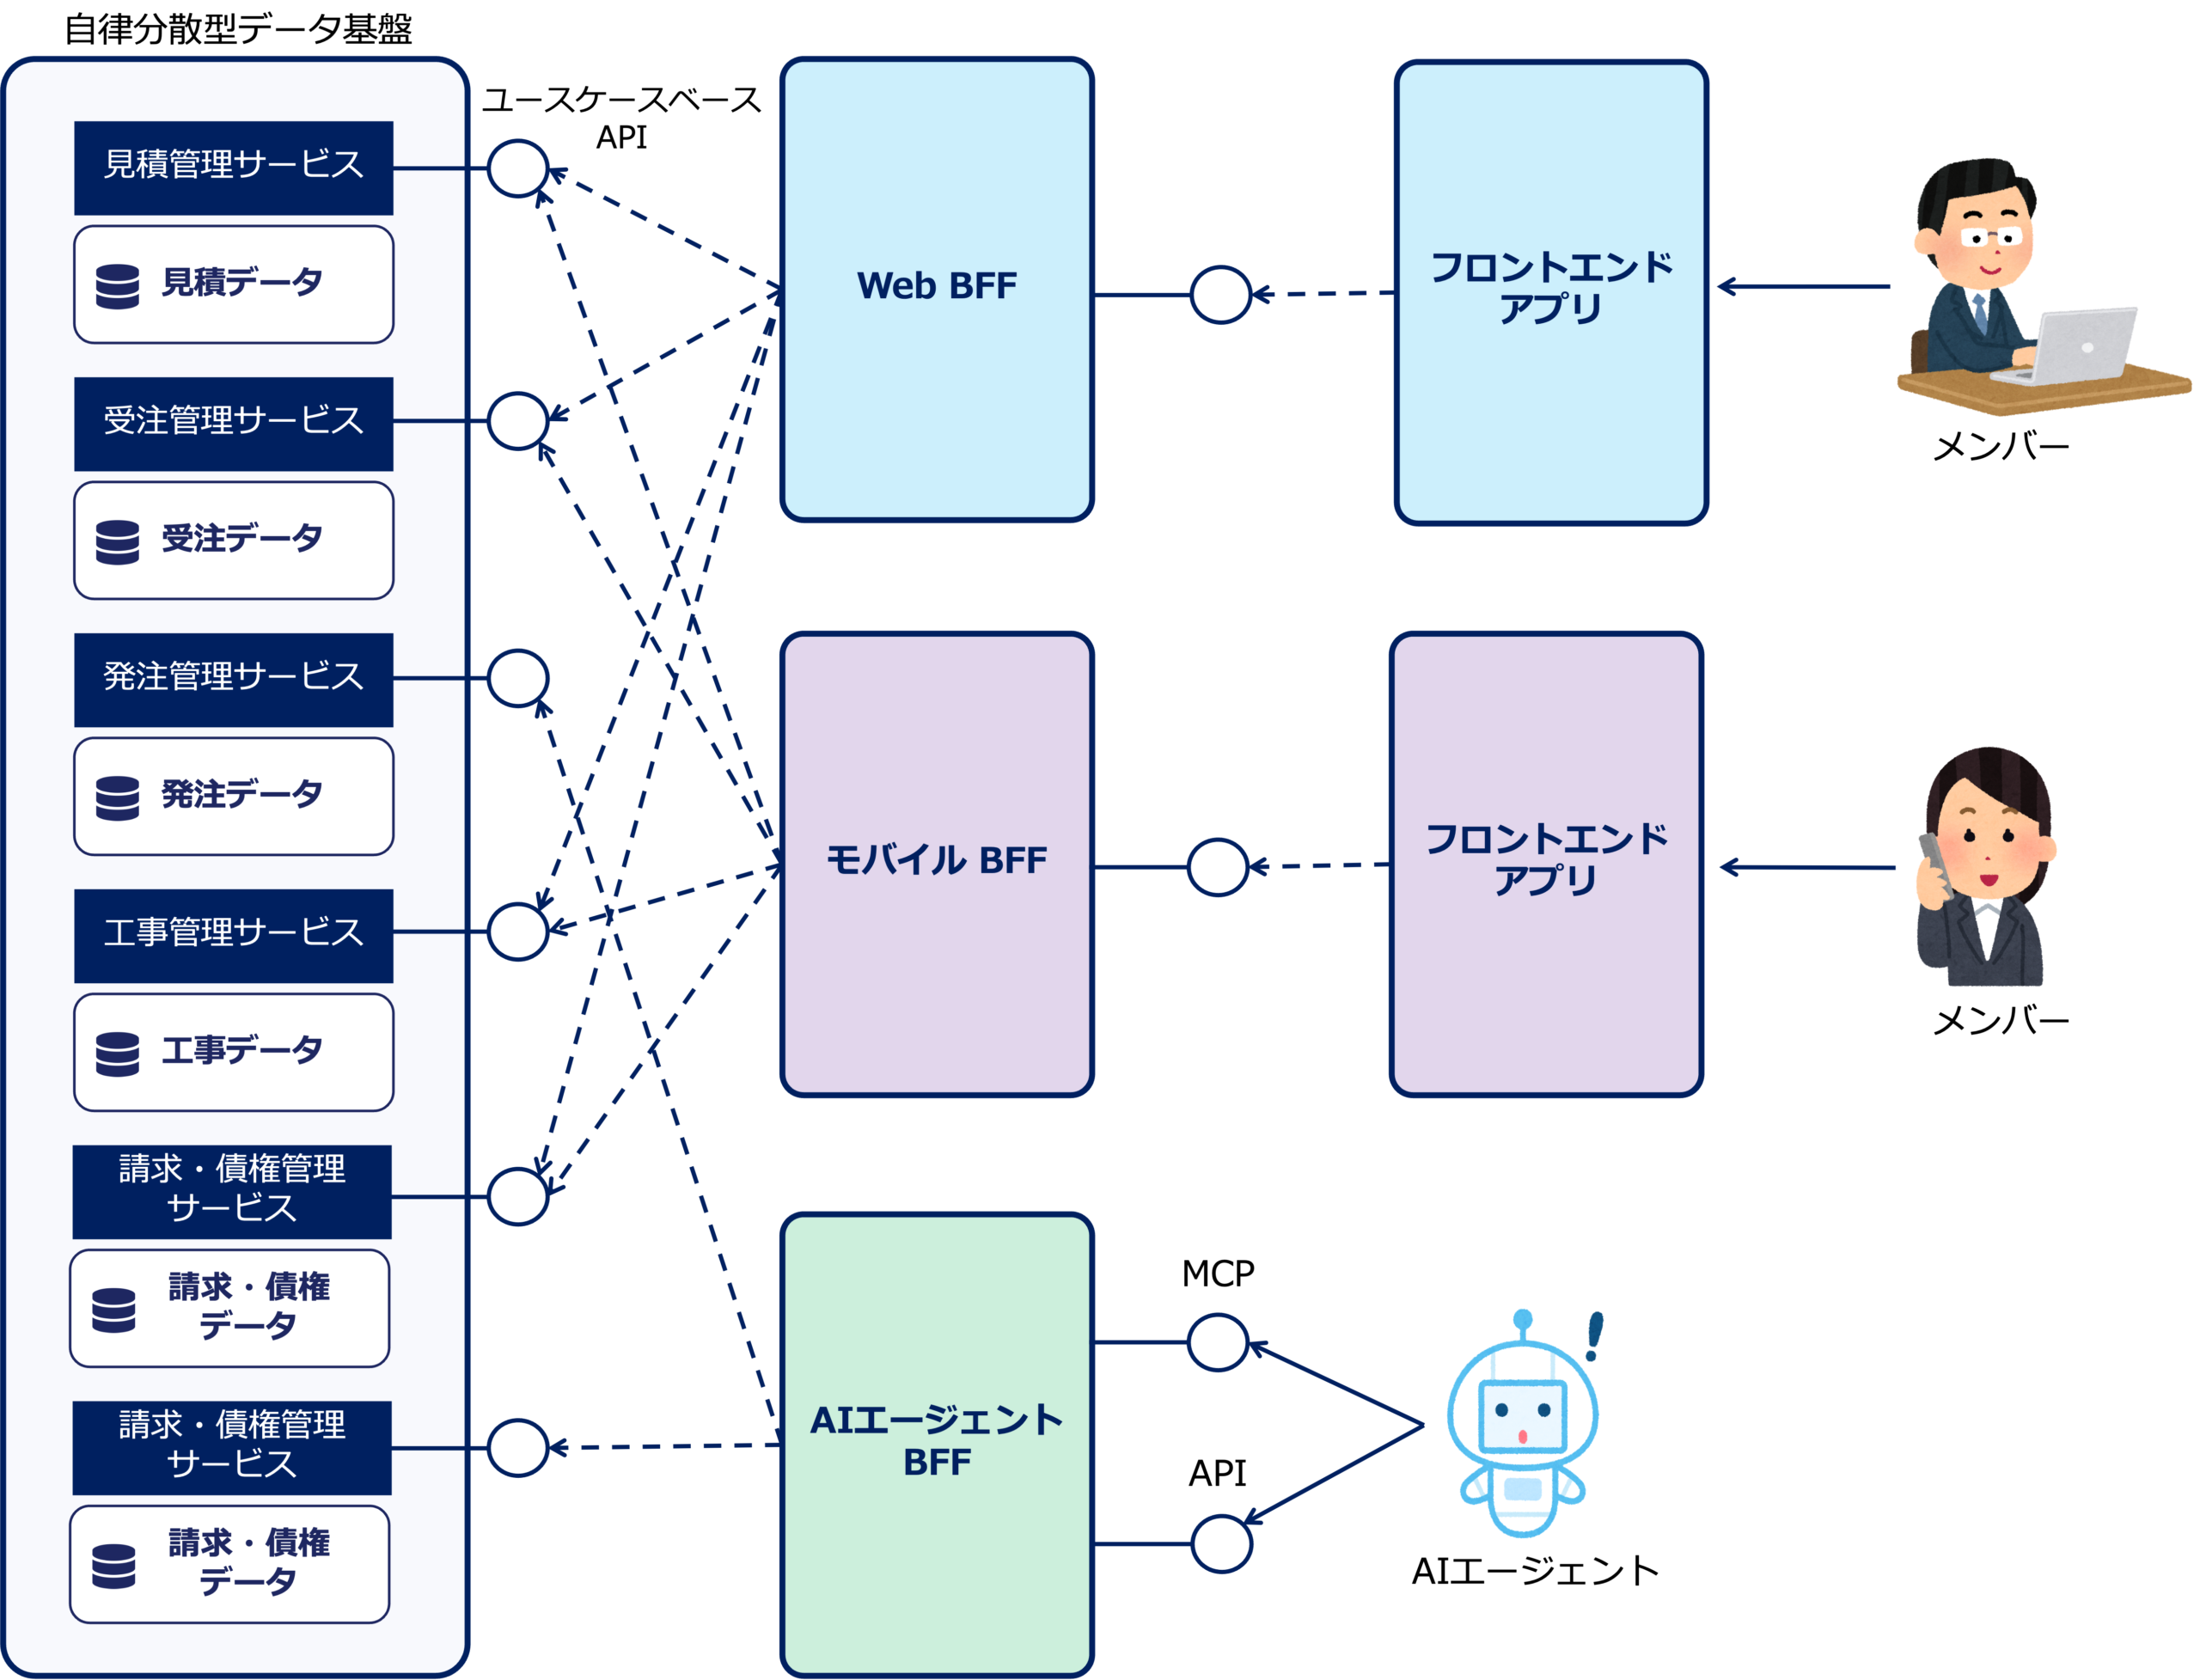
次の図は、メンバーやAIエージェントが自律分散型データ基盤にアクセスする様子を示したものです。
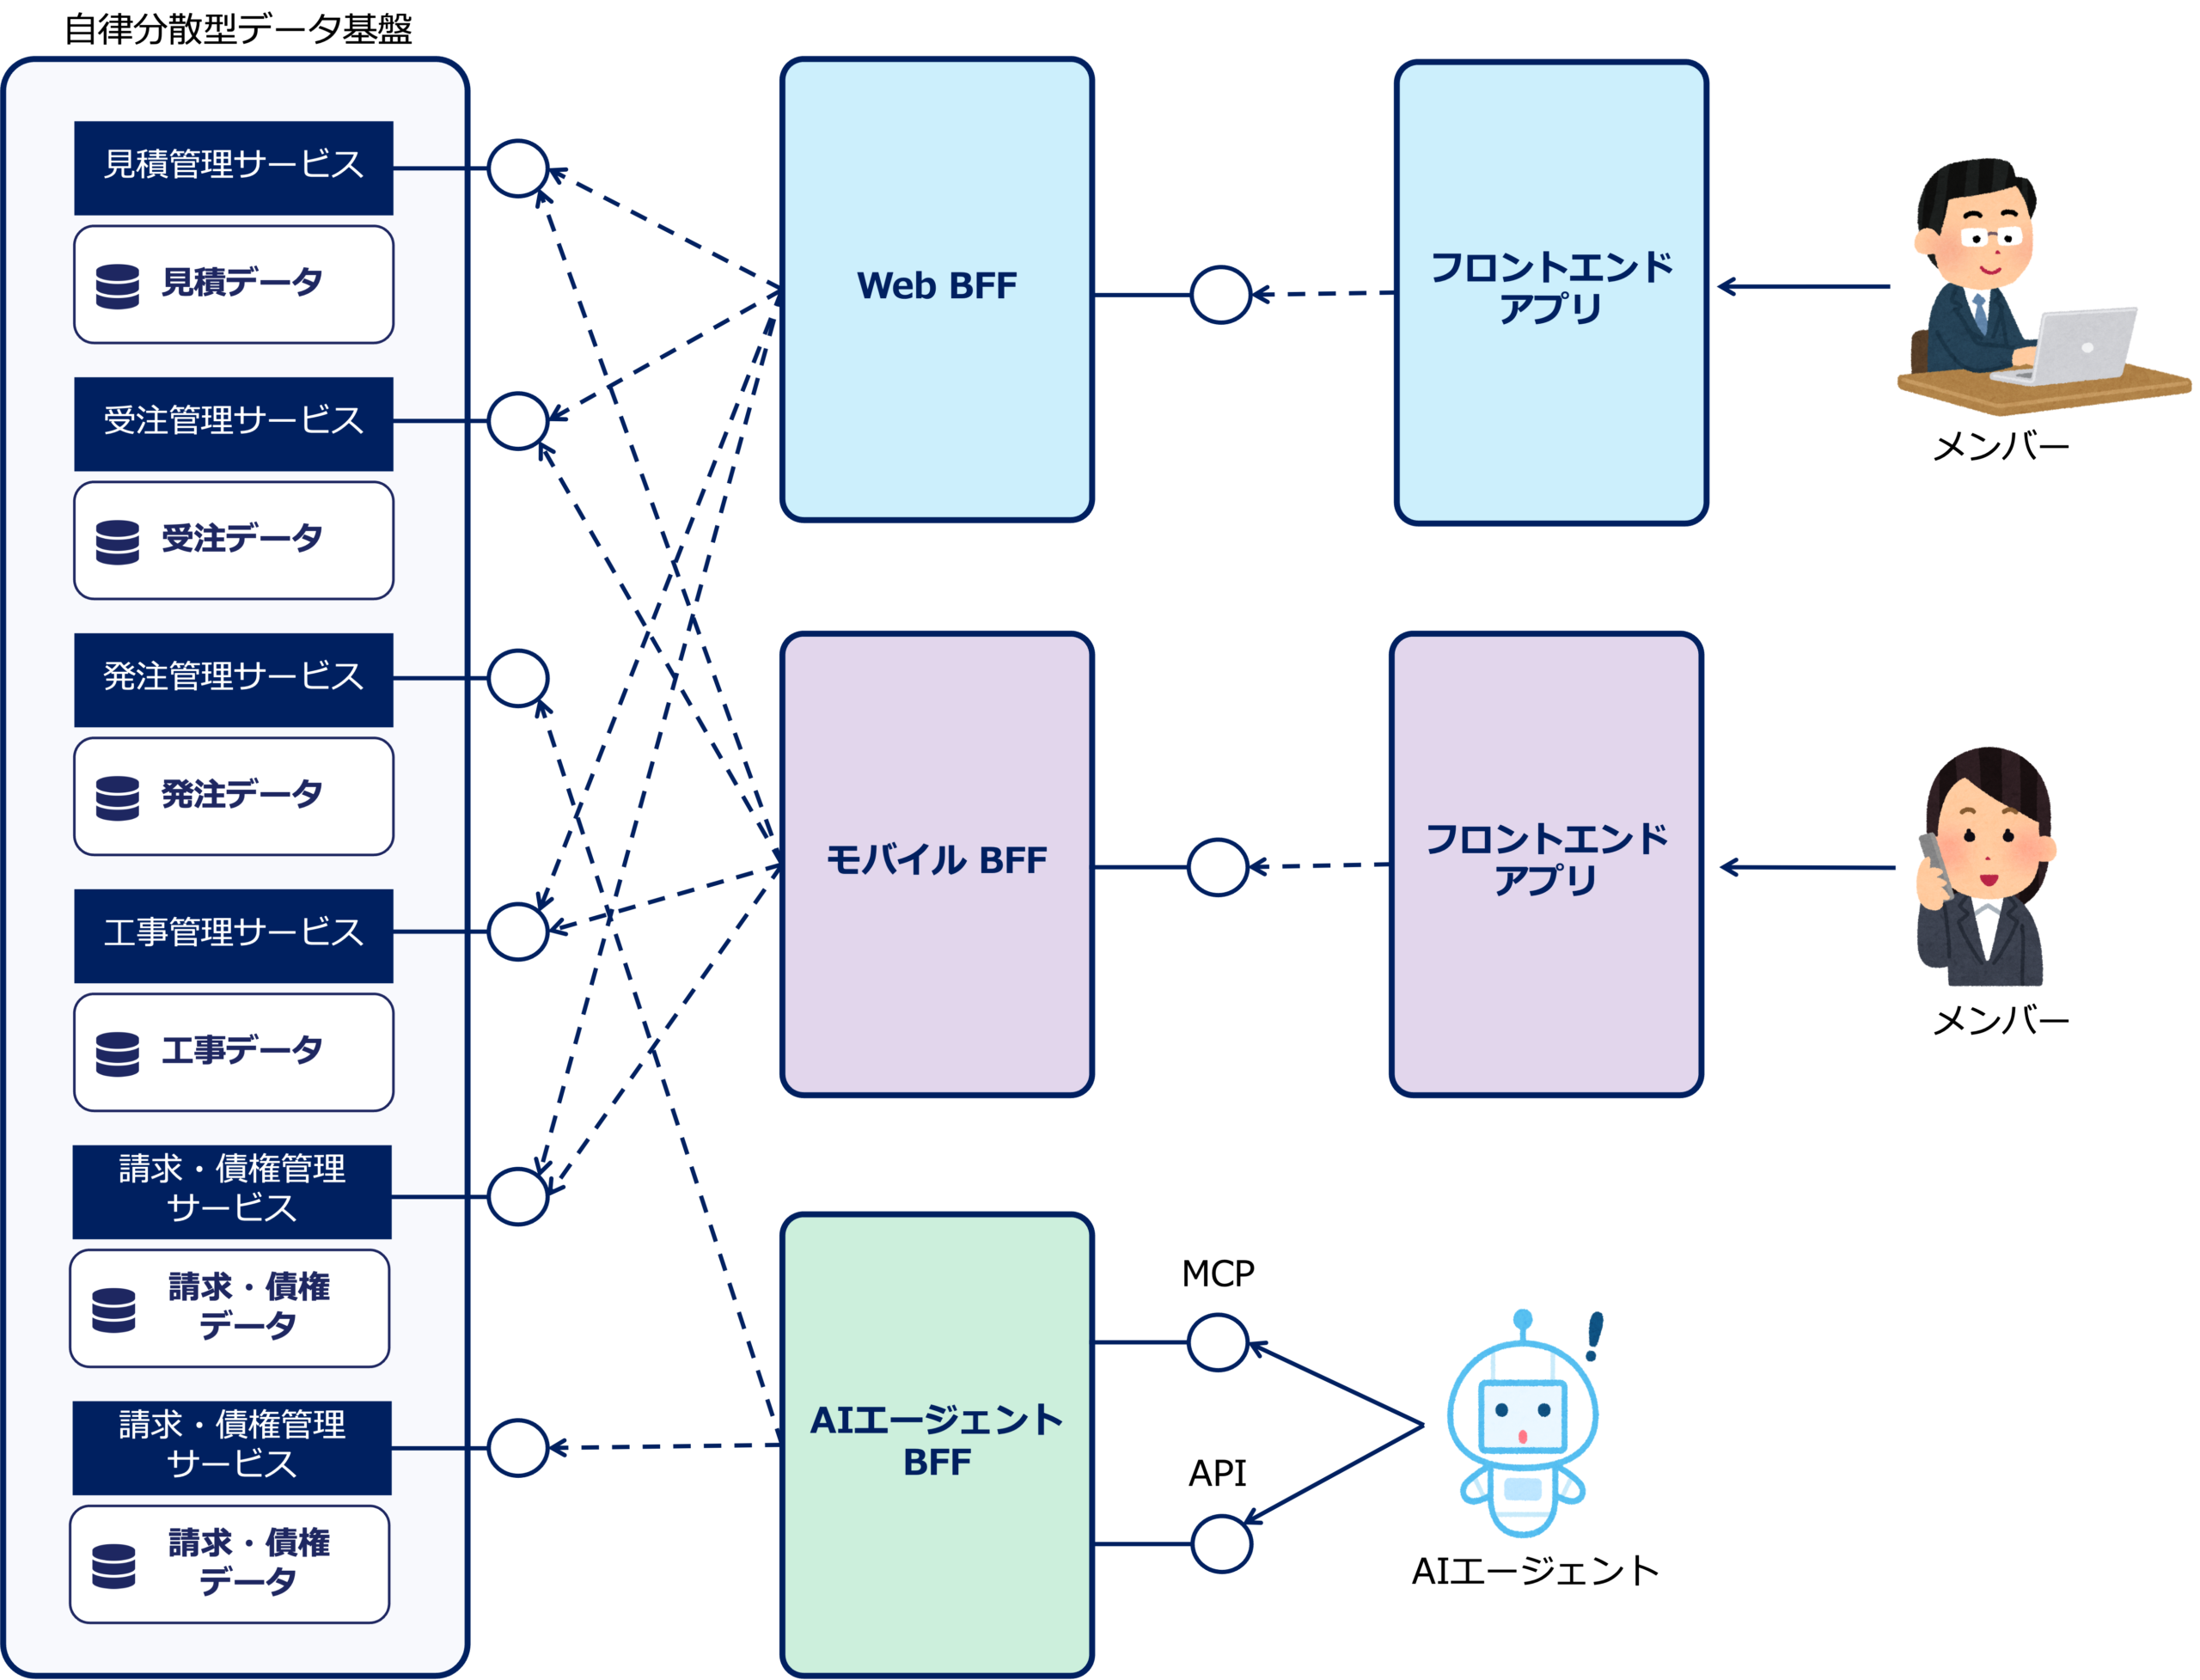
BFF(Backend for Frontend)とは、フロントエンドアプリやAIエージェントなどの利用主体に応じて、複数の業務マイクロサービスが提供する機能やデータを統合・最適化して提供するサービスです。
BFFの主なメリットは次のようになります。
- 利用主体ごとの最適化
Web、モバイル、AIエージェントそれぞれに適したAPIを提供できる - 依存関係の分離
マイクロサービスの内部構造や構成変更による影響を抑えられる - 通信の効率化
複数サービスのデータを統合し、クライアントからのAPI呼び出し回数を削減できる - セキュリティの統一
認証・認可、アクセス制御などを利用主体に応じて実施できる - 開発の独立性
フロントエンドと業務マイクロサービスを独立して開発・変更しやすくなる
この図のように、メンバーやAIエージェントはAPIやMCPを介して自律分散型データ基盤にアクセスします。
自律分散型データ基盤の特徴
自律分散型データ基盤の特徴は次の3つです。
会社の重要なデータの品質とセキュリティを確保することができる
自律分散型データ基盤は、信頼性や機密性の高いデータをマイクロサービスにカプセル化します。
MECEに分割された業務ドメイン単位で「One Fact in One Place」を実現することで、データの散在を防ぎ、データ品質とセキュリティを担保することができます。
これにより、自律分散型データ基盤は、信頼できる会社で唯一のデータソース(single source of truth)を確立します。
さて、集中型のデータ基盤も、会社のデータを中央で一元管理するのでデータの品質やセキュリティを確保することができるのではないかと考えることがあります。
しかし、集中型のデータ基盤では、一元化されたデータ構造に多くの処理が依存するため、データ構造が変更されると多くの処理に影響が及ぶという問題が発生します。
DOAの思想の根底には、
「処理は業務改善などによって頻繁に変わるが、業務の本質を表すデータ構造は比較的安定している」
という考え方があります。
しかし実際には、データ構造も属性の追加や関係の拡張など、少しずつ変化していきます。
その結果、全体で一元化されたデータにアクセスする処理が増えるほど、データ構造変更の影響範囲が拡大し、処理の追加や変更の柔軟性が低下していきます。
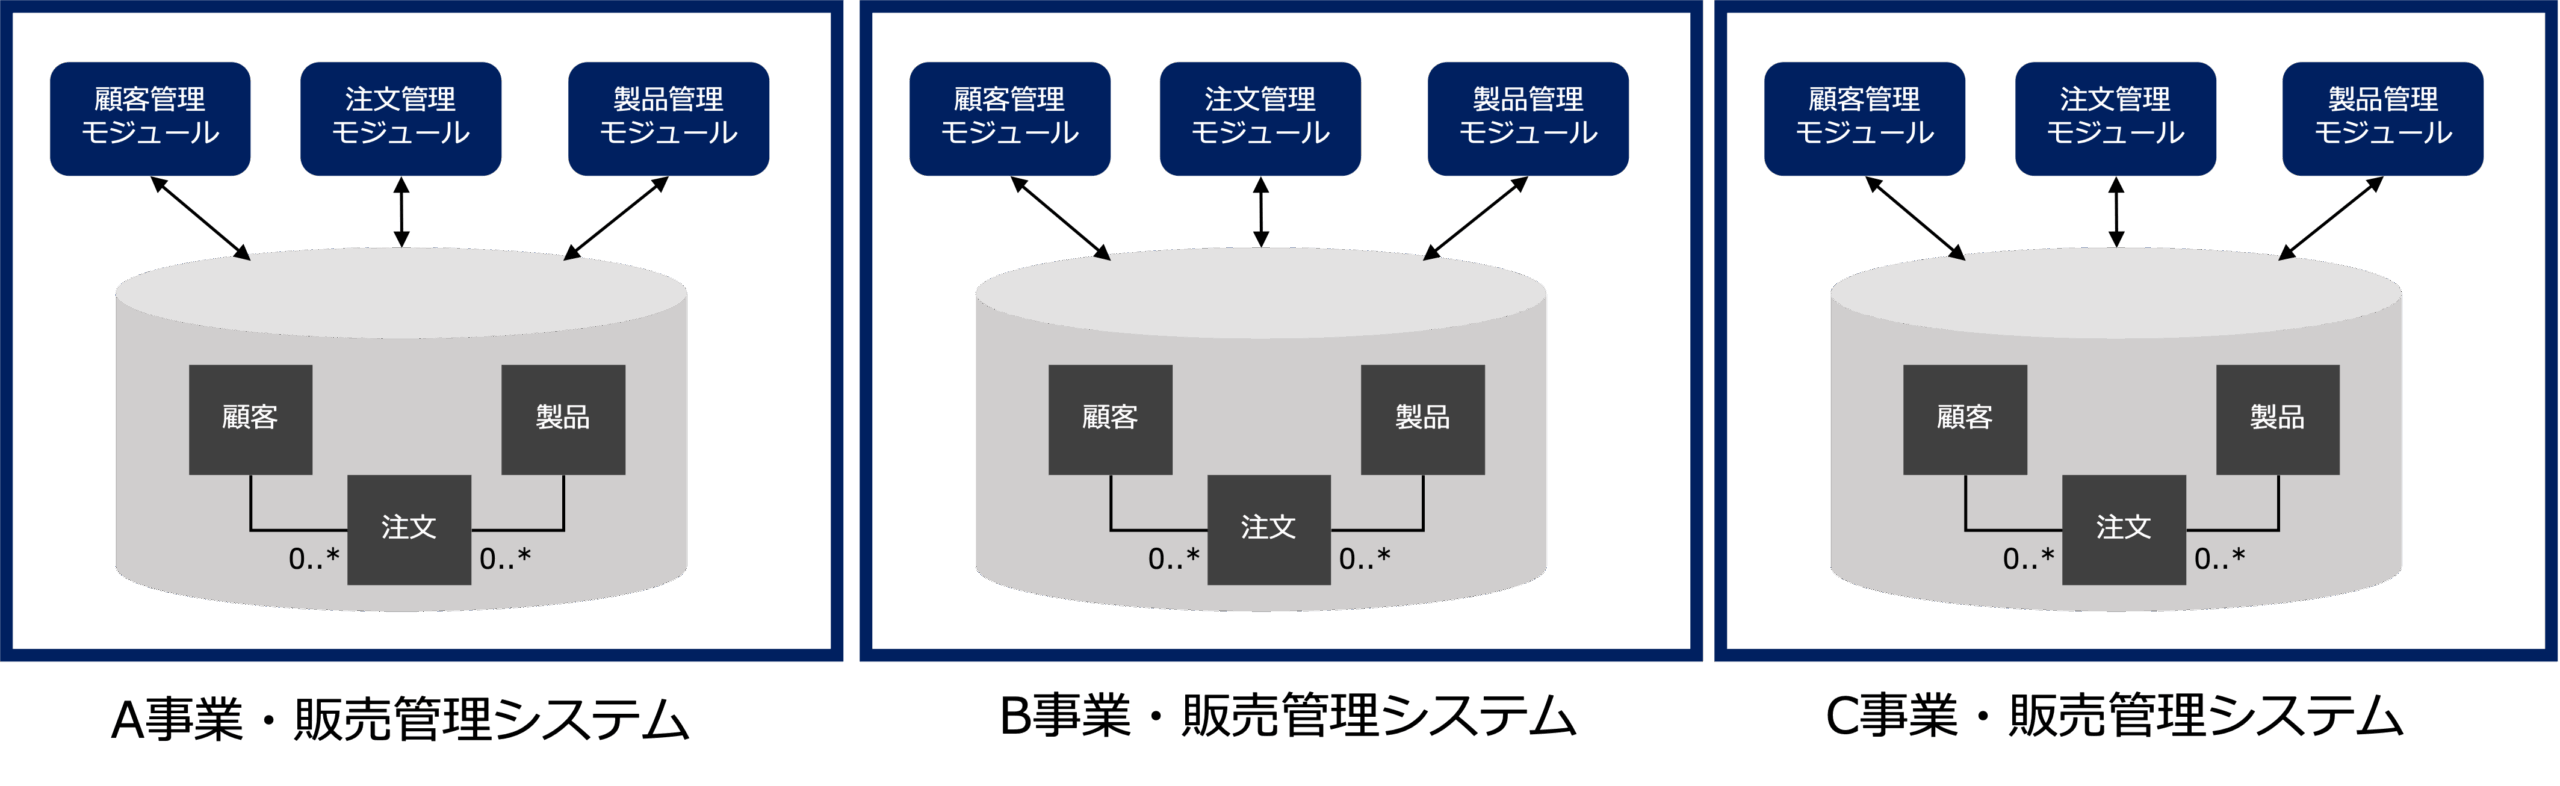
例えば、企業全体の業務機能とデータをパッケージ化して提供する業務パッケージを考えてみましょう。
業務パッケージの場合、企業の全業務の機能とデータを統合する(囲い込む)ことを前提として設計されているため、パッケージ内部で機能とデータが複雑に絡み合っており、機能の改修や追加にかかるコストが高くなります。
また、業務パッケージは、それを構成するモジュール同士がマイクロサービスアーキテクチャのようにAPIや非同期通信を通して連携できるように設計されていないため、業務モジュール単位で分割して導入すると、他のパッケージやシステムとの連携が困難になります。
結果的に、企業内に、独立した業務パッケージが乱立し、システムと業務のサイロ化が進むことになります。
会社の業務とシステムを変化に強い構造にすることができる
マイクロサービスは、会社の業務ドメインごとに、ビジネスロジックをシステム機能としてカプセル化し、モジュール化します。
モジュール化とは、ビジネスやシステムを構成する要素を、論理的な仕様(インターフェース)と、それを実現する物理的な手段に分けて設計(仕様と実装の分離)し、構成要素を利用する相手に対してインターフェースのみ公開することで、物理的手段やデータを相手から隠蔽し(ブラックボックス化)自由に交換可能にすることです。
業務の機能単位であるマイクロサービス同士をインタフェースによって疎結合することで、変更による影響を最小にする保守性の高い仕組みを実現することができます。
また、マイクロサービスをソフトウェア部品として組み合わせることで新しいシステムを開発することでシステム開発の生産性を劇的に上げることができます。
例えば、マイクロサービスによって、次のようなソフトウェア設計原則を実現することができます。
- 単一責任の原則
マイクロサービスは、特定の業務ドメインのビジネスロジックをその中に閉じ込めるので、ビジネスロジックの散在を防ぎます。
これにより、特定の業務の仕様が変わった場合、特定のマイクロサービスだけ変更すればよく、業務の変更によるリスクを局所化することができます。 - 開放閉鎖(Open/Close)の原則
マイクロサービスは、既存のインタフェース(仕様)を変更せずに内部実装を改修するように設計することができます(修正に閉じる)。
これによって、利用者は機能修正による影響を受けることがありません。
また、既存のインターフェース(契約)を壊さず、新しいインターフェースやイベントとして機能を拡張することができます(拡張に開く)。
これによって、利用者は拡張された機能を利用するタイミングを選べるため、その影響を最小化することができます。
会社の業務とシステムを自律化することができる
自律分散型データ基盤は、業務機能をマイクロサービス単位でカプセル化し、疎結合で連携させる分散型のデータ基盤です。
企業の基幹システムを構成する業務機能が、それぞれ自律したマイクロサービスとして構成され、イベント駆動やAPIによって相互に連携することで、会社の業務とシステムを自律化することができます。
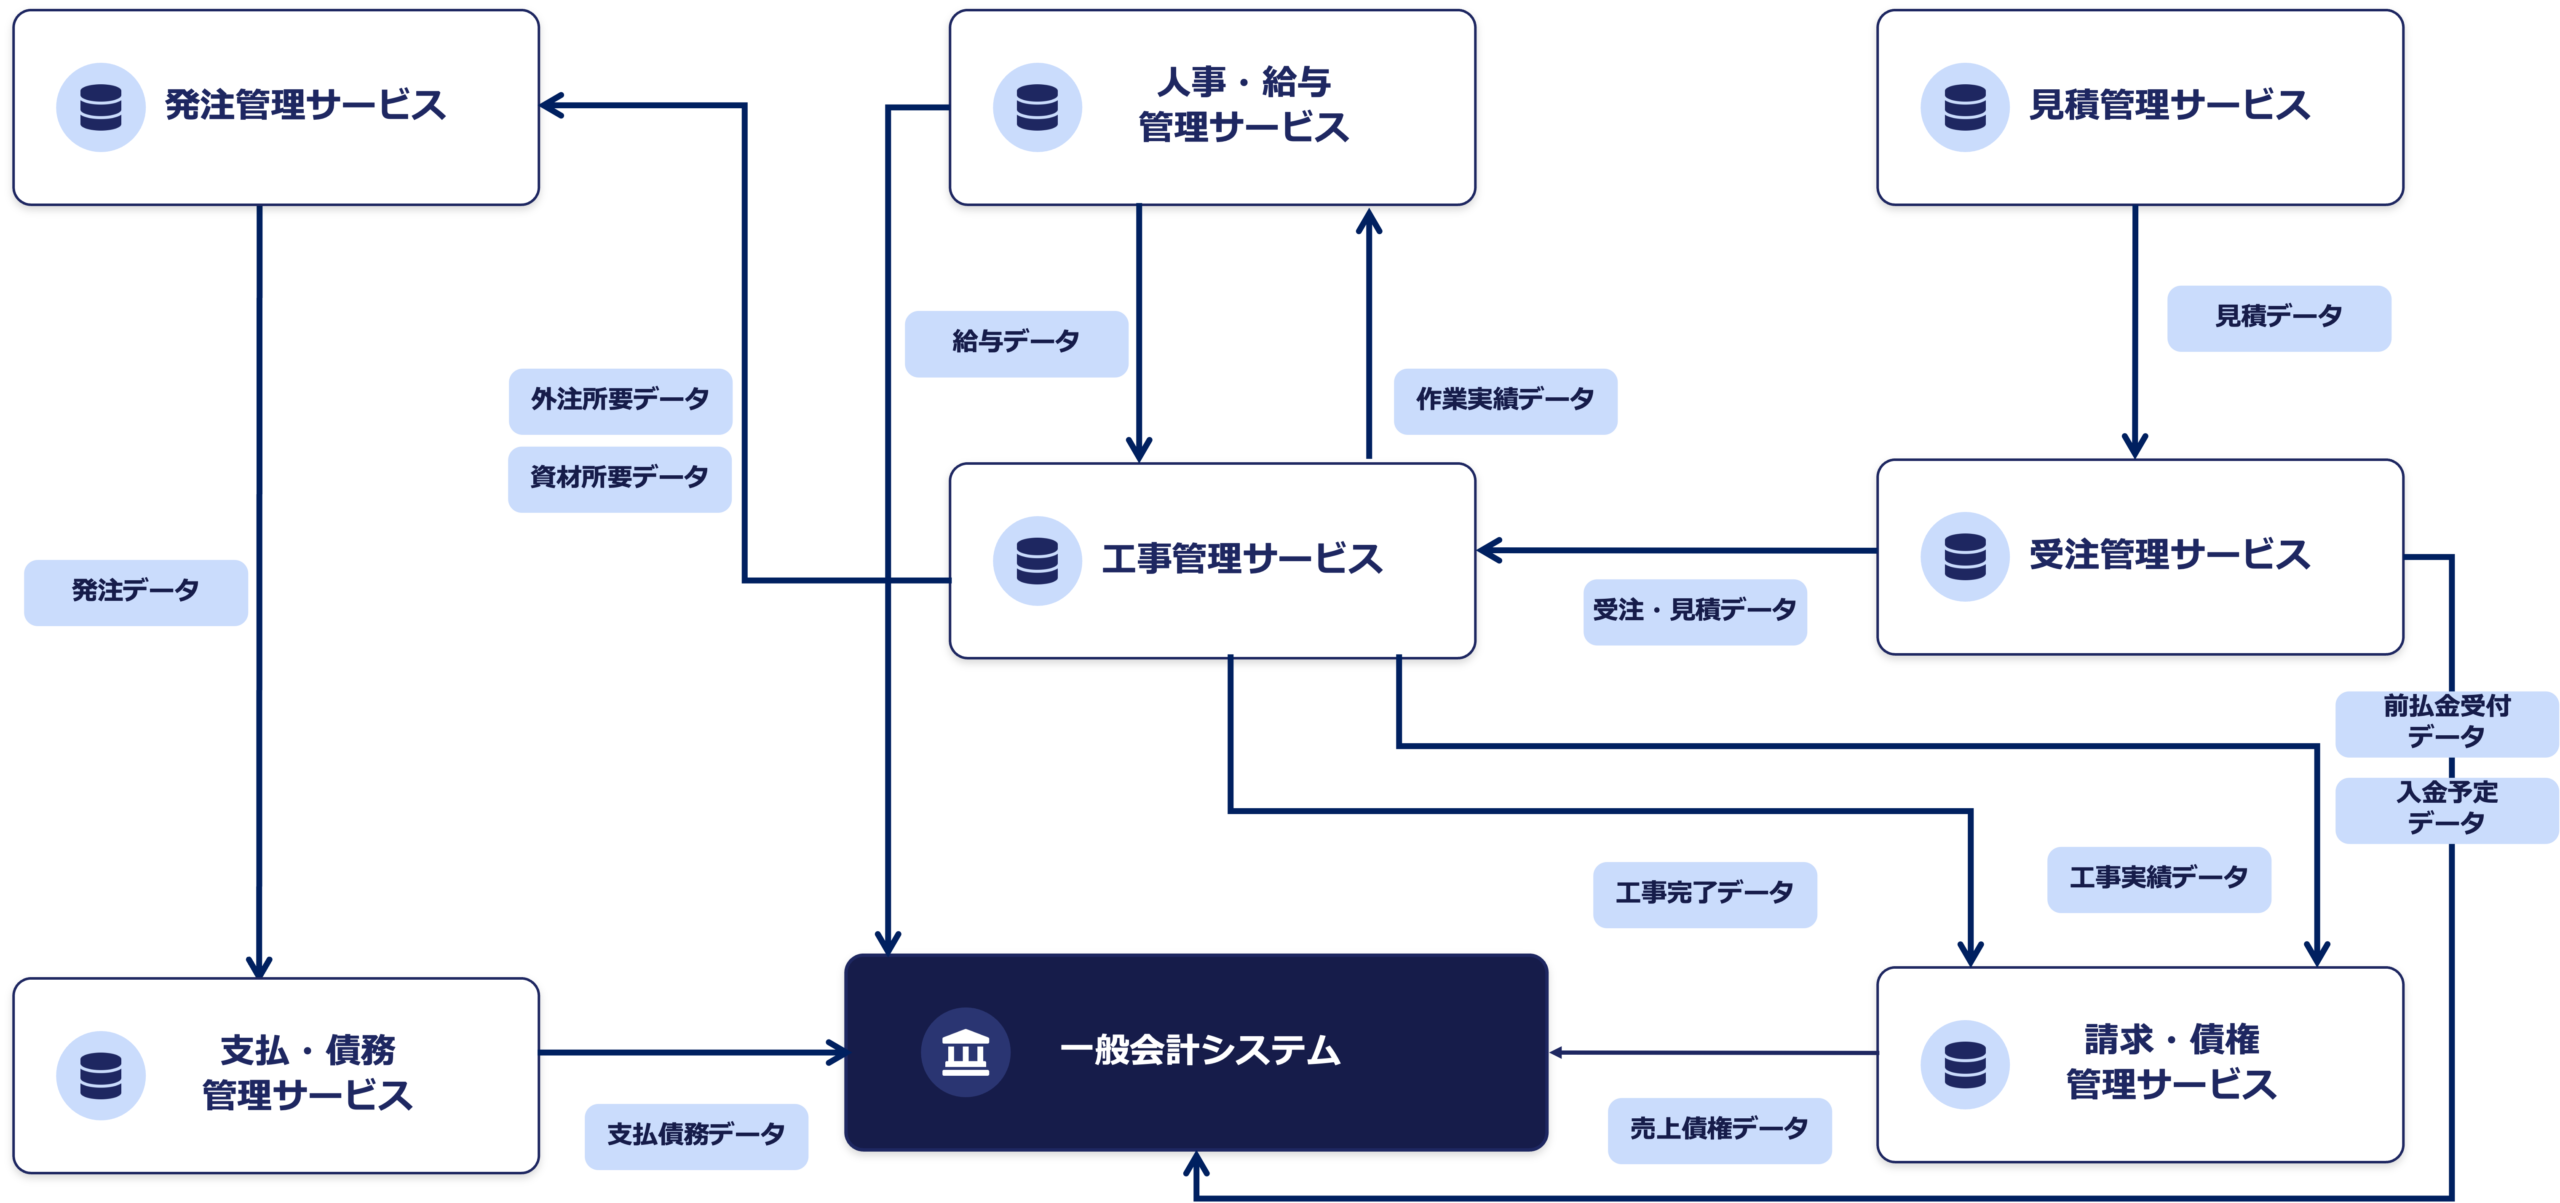
会社の業務とシステムを自律化することの最大のメリットは、人による判断・指示・調整への依存を減らし、環境の変化に対して迅速かつ柔軟に対応できるようになることです。
具体的には、次のようなメリットがあります。
- 生産性の向上
人による指示や調整、手作業を減らし、より少ないリソースで多くの業務を処理できる - 迅速性の向上
上位組織の判断や他システムの処理を待たずに、各業務システムが自律的に判断・実行できる - 柔軟性の向上
業務やシステムを独立して変更できるため、環境変化や新しい要求に柔軟に対応できる - 拡張性の向上
業務やシステムを独立して追加・拡張できるため、事業の成長に対応しやすくなる - 継続性の向上
一部の業務やシステムに問題が発生しても、影響を局所化し、他の業務を継続できる
自律分散型データ基盤のAPI
自律分散型データ基盤の構造で説明したように、AIエージェントはAPIを介して自律分散型データ基盤にアクセスします。
ここでは、自律分散型データ基盤のAPIで注意すべき点について説明します。
基幹システムの多くは、
UIを司るプレゼンテーション層、
ビジネスロジックを司るアプリケーション層、
データアクセスを司るデータ層から構成される、
3階層アーキテクチャを採用しています。
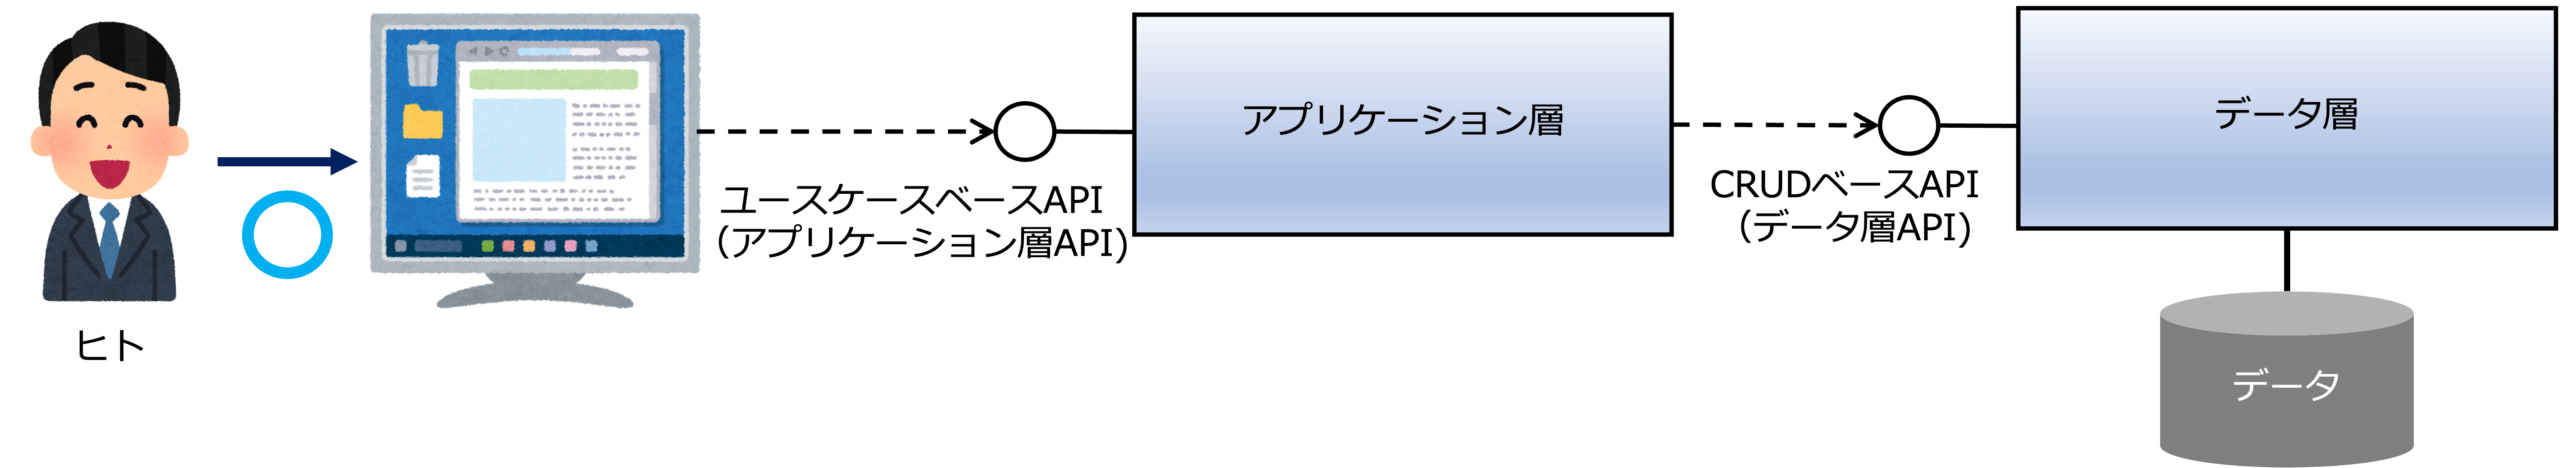
この構成を前提とすると、基幹システムがAPIを提供する場合、アプリケーション層のAPIとデータ層のAPIの二種類を考えることができます。
データ層のAPIは、データベースに対するCRUD(Create/Read/Update/Delete)操作を中心としたAPIであるのに対し、アプリケーション層のAPIは、ビジネスロジックや業務ルールを含んだユースケースベースのAPIとなります。
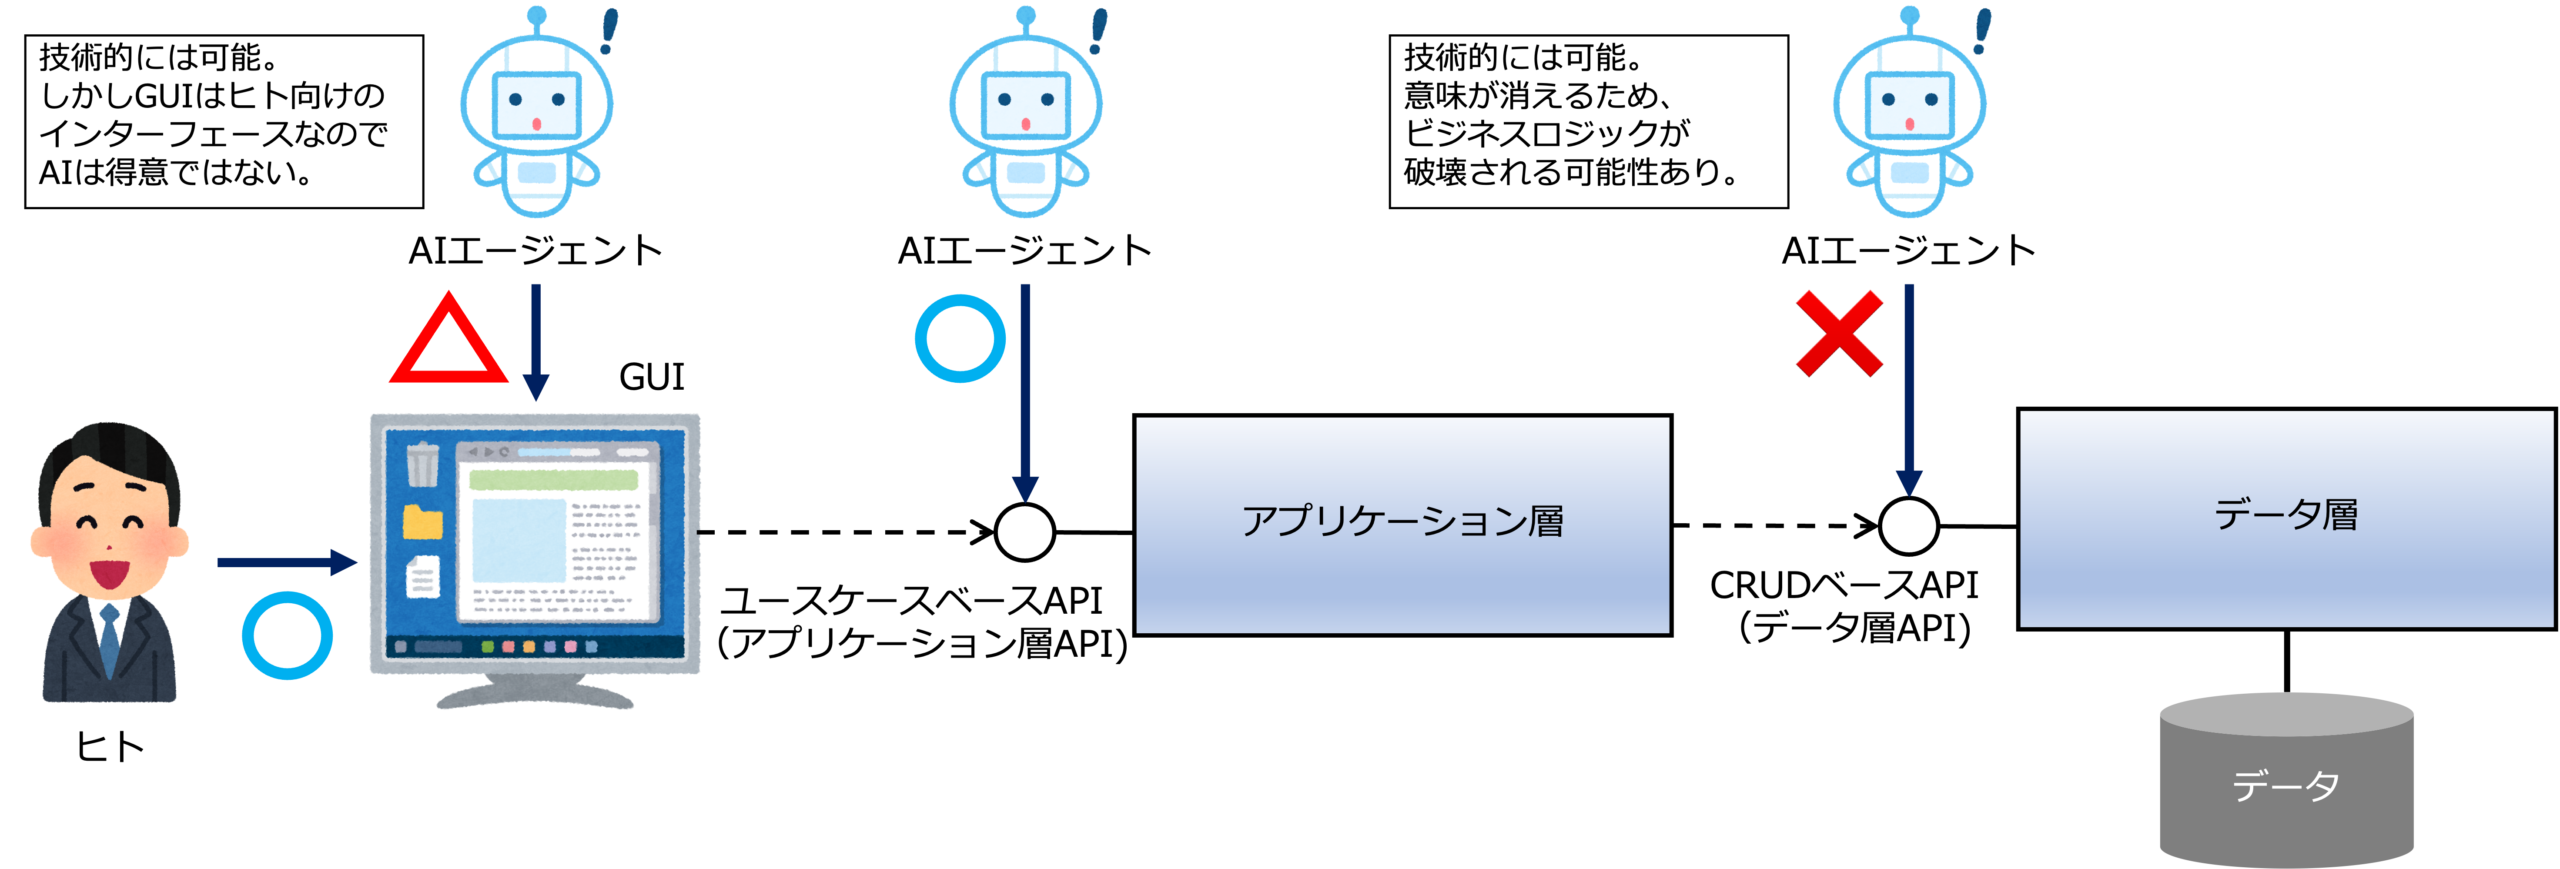
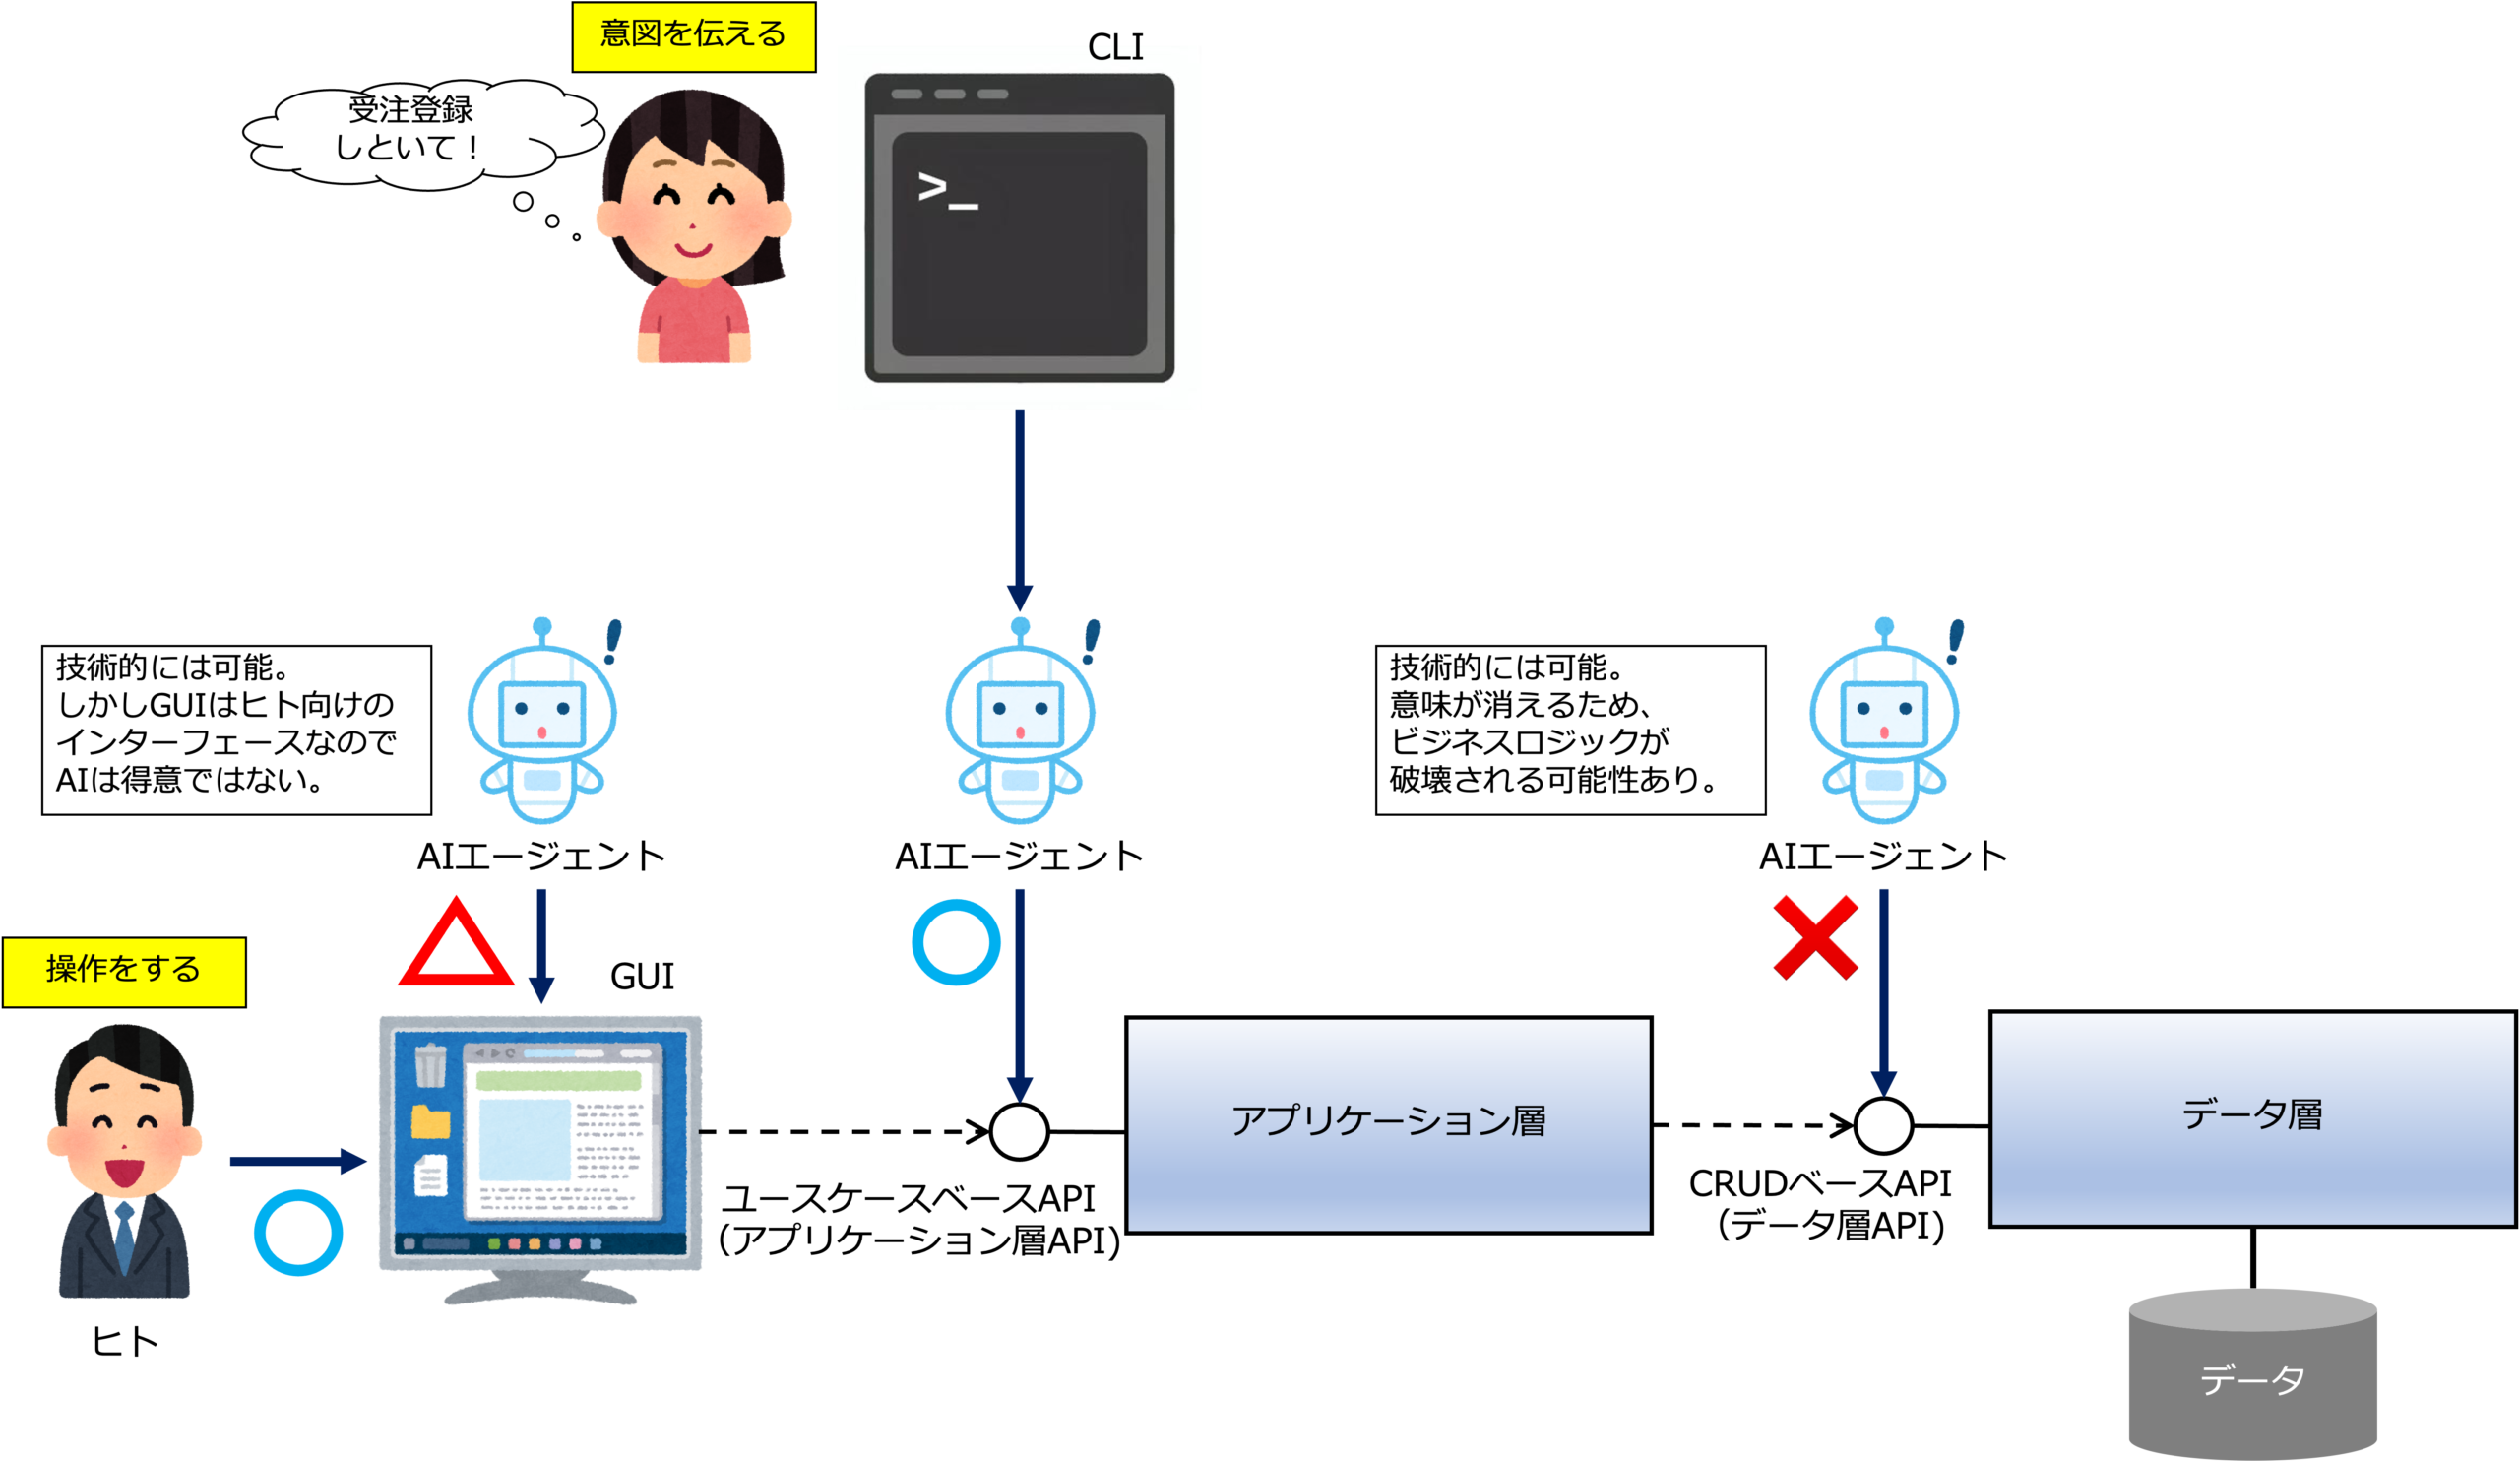
これらのうち、AIエージェントに公開すべきAPIは、CRUDベースのAPIではなく、ユースケースベースのAPIです。
なぜなら、AIエージェントがCRUDベースのAPIを直接操作すると、本来アプリケーション層で担うべきビジネスロジックが迂回され、結果として、データの整合性が損なわれ、信頼できないデータが蓄積されるリスクがあるためです。
仮に、ビジネスロジックが完全に文書化され、AIが常に正確にそれを解釈し、例外ケースも網羅され、将来の変更にも即時に追従できるのであれば、CRUDベースのAPIのみを公開しても運用できる可能性はあります。
しかし、実際にはルールは常に変化し、例外も頻発し、さらに法規制や監査要件も存在します。そのような状況において、AIエージェントが常に正しく推論できることを前提とする設計は現実的ではありません。
定型的な処理は、AIエージェントよりも従来のアプリケーションが担う方が良いと考えられます。
全てのアプリケーションにAIが接続されたAIネイティブの世界では、ヒトは「GUIを操作する」存在ではなく、「意図を伝える」存在へと変わるのではないでしょうか。
自律分散型データ基盤は、ユースケースベースのAPIで構成されており、AIエージェントがより安全に会社の業務データにアクセスすることができる環境を提供します。
自律分散型データ基盤の構築方法
生成AIの急速な進化によって、アプリケーション開発のあり方が劇的に変わりつつあります。
これまでIT技術者の専門領域だったアプリケーション開発は、生成AIとの協働によって、業務を熟知した非エンジニアにも開かれたものになりました。
業務を知る人が、自ら業務を変えるアプリケーションをつくる
そんなアプリケーション開発の民主化が進んでいます。
このとき、懸念されるのがデータとアプリケーションの散在化です。
自由にアプリケーションが作れると、似たようなアプリケーションや、例えば、顧客データや商品データなどアプリケーションごとに管理される同じデータが増殖する可能性があります。
これは、
- データの散在による企業全体のデータ品質やセキュリティの低下
- 同じ機能を再生産することによる生産性・保守性の低下
を招きます。
特に、クラウドベースのノーコード系開発環境でアプリケーションを開発する場合、アプリケーションごとにデータが蓄積されるので、好き勝手にアプリケーションを作れば作るほどデータが散在していくとになります。
かつて、EUC(エンドユーザーコンピューティング)でExcelや簡易アプリ上にデータが散在していき、結果的に、カオスで雁字搦めの状況を招いた二の舞になってしまうのです。
まさに「楽あれば苦あり」です。
このようなデータの散在や無駄な開発を防ぐ有効な手段がマイクロサービスです。
ビジネスロジックとデータをマイクロサービスとしてカプセル化することによって、信頼できるデータと機能を一箇所で管理することで、データクオリティとデータセキュリティが担保されるとともに、マイクロサービスを部品として利用することで生産性や保守性も向上します。
信頼できるマイクロサービスのAPIを使って、UI/UXを担うフロントエンドアプリケーションを非エンジニアがアジャイルに開発することで、ビジネスとITが両輪となって、会社の業務とシステムを、環境の激しい変化に柔軟に適応できる変化に強い構造にすることができると考えています。
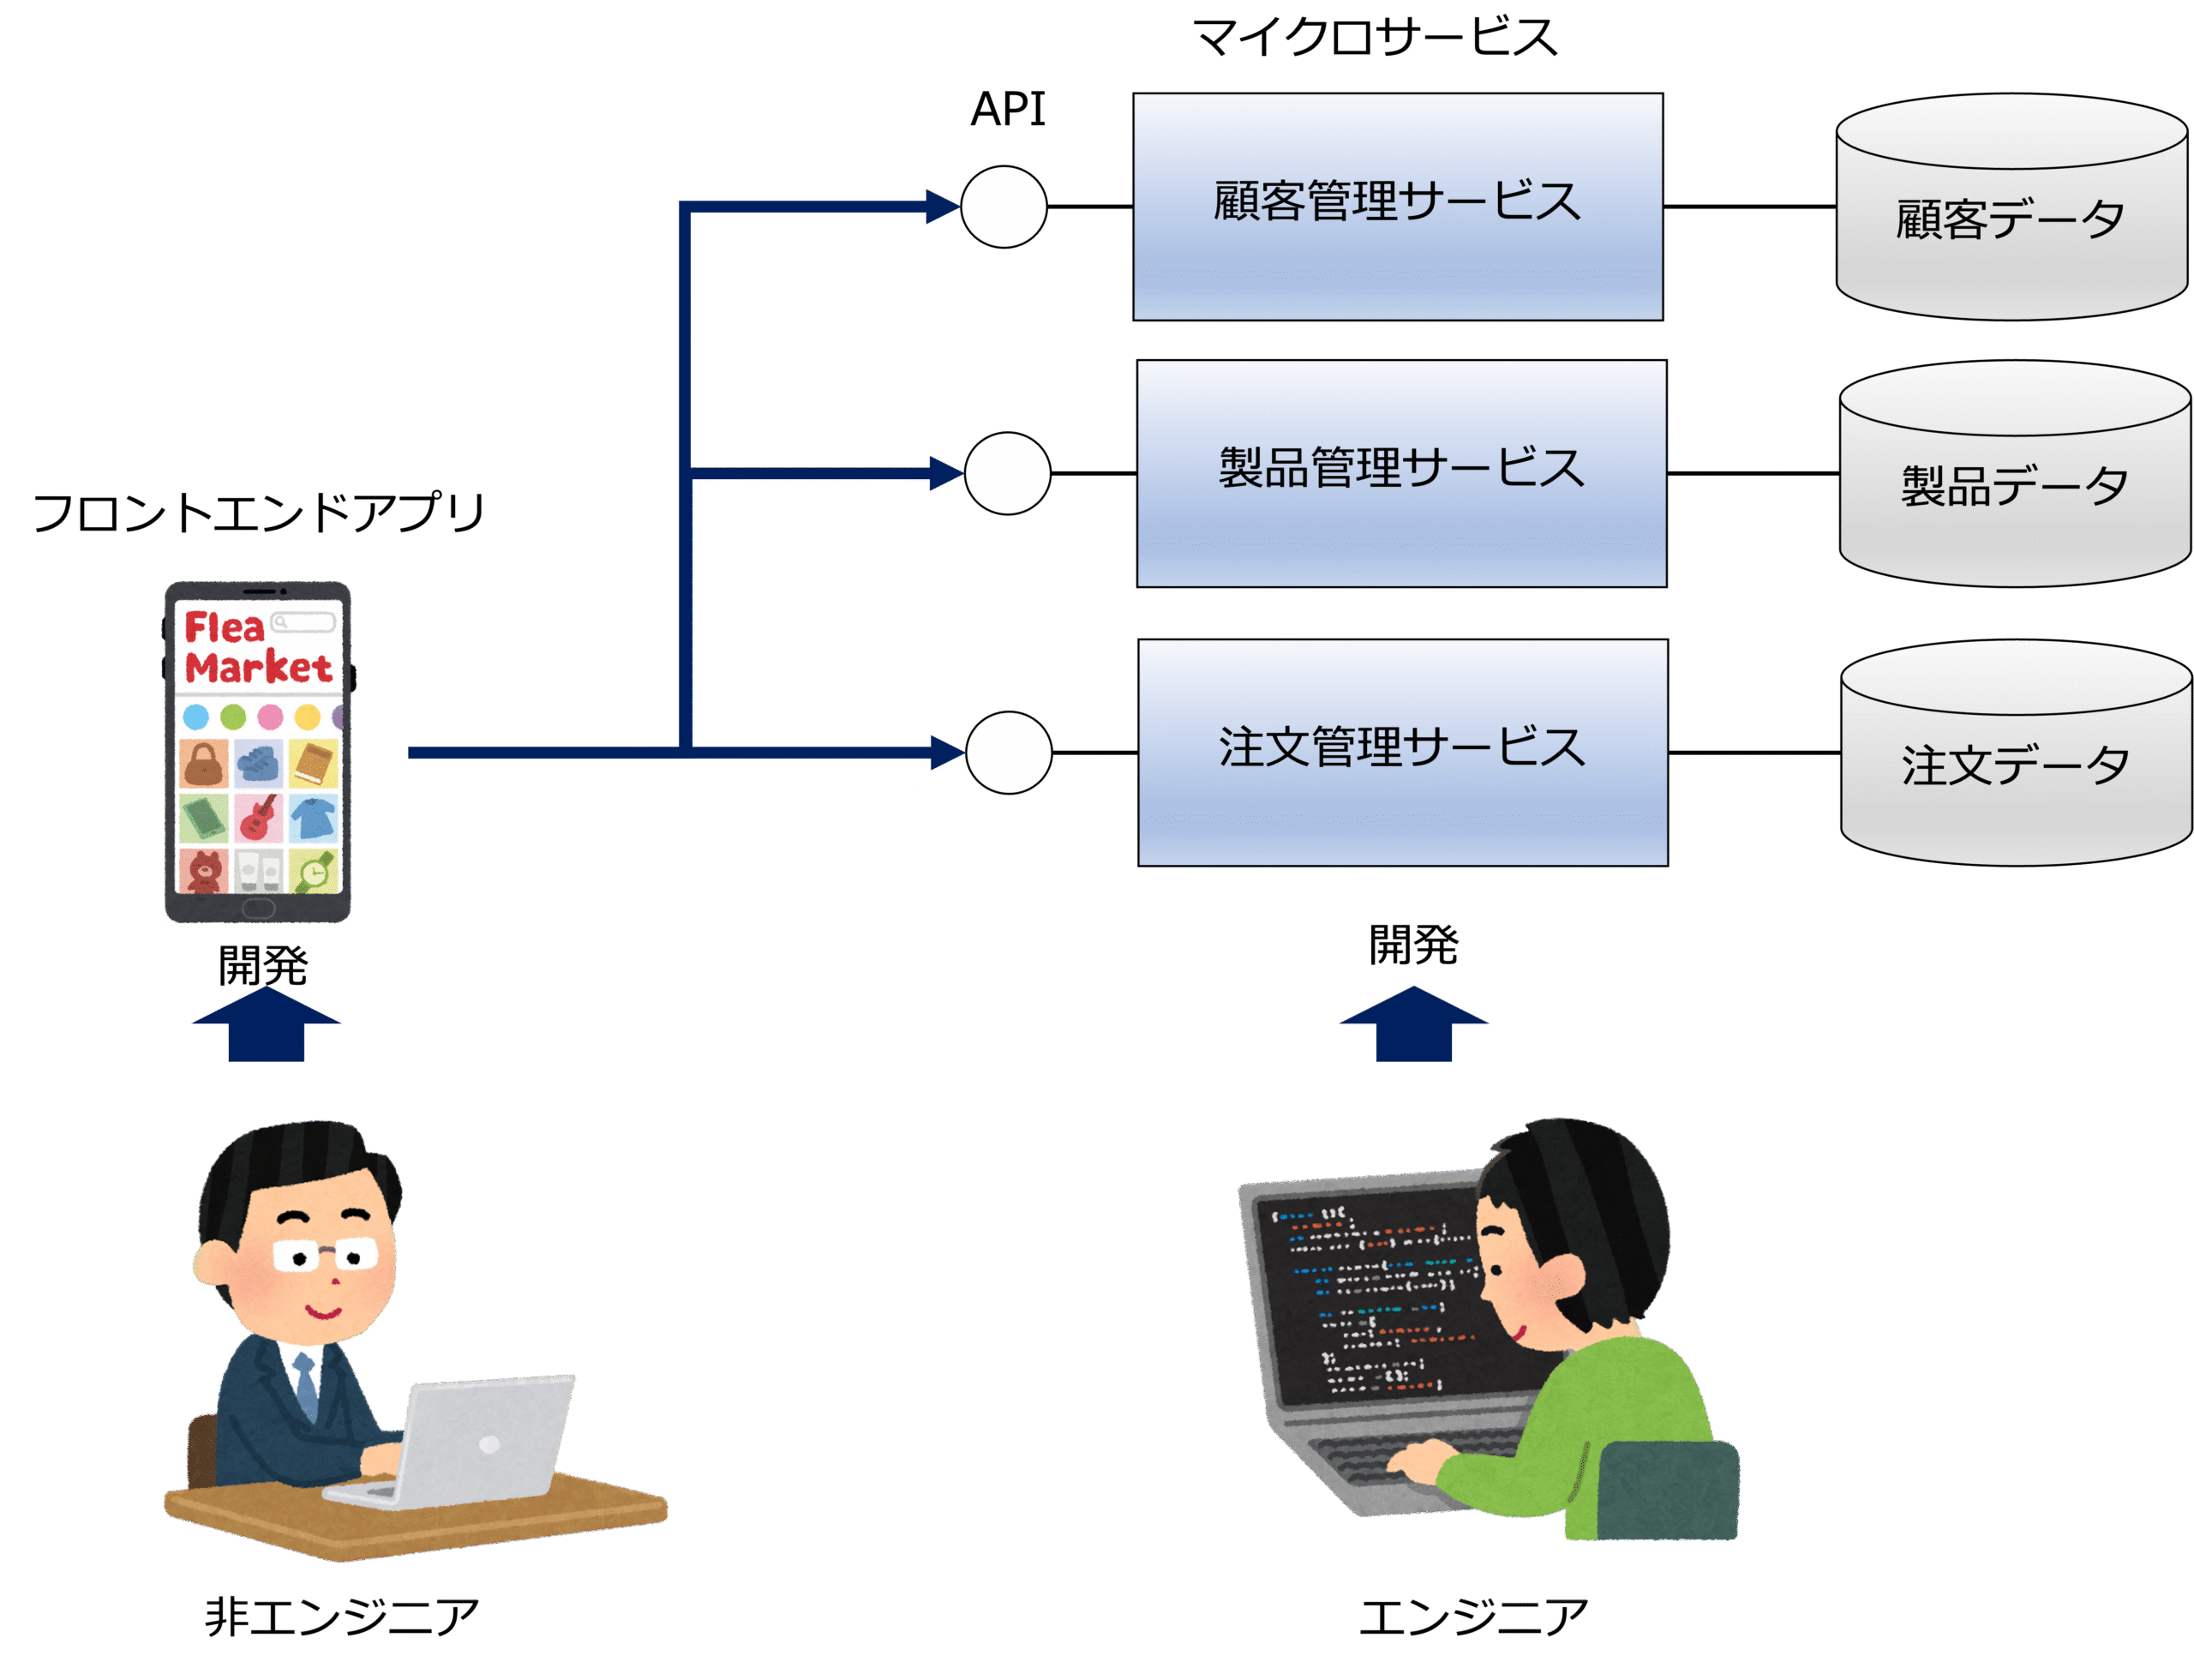
自律分散型データ基盤であれば、信頼性と安全性を求められる自律分散型データ基盤をエンジニアが構築し、業務知識を求められるフロントエンドアプリを非エンジニアが開発すれば一貫性のある基幹システムを構築できるのではないでしょうか。
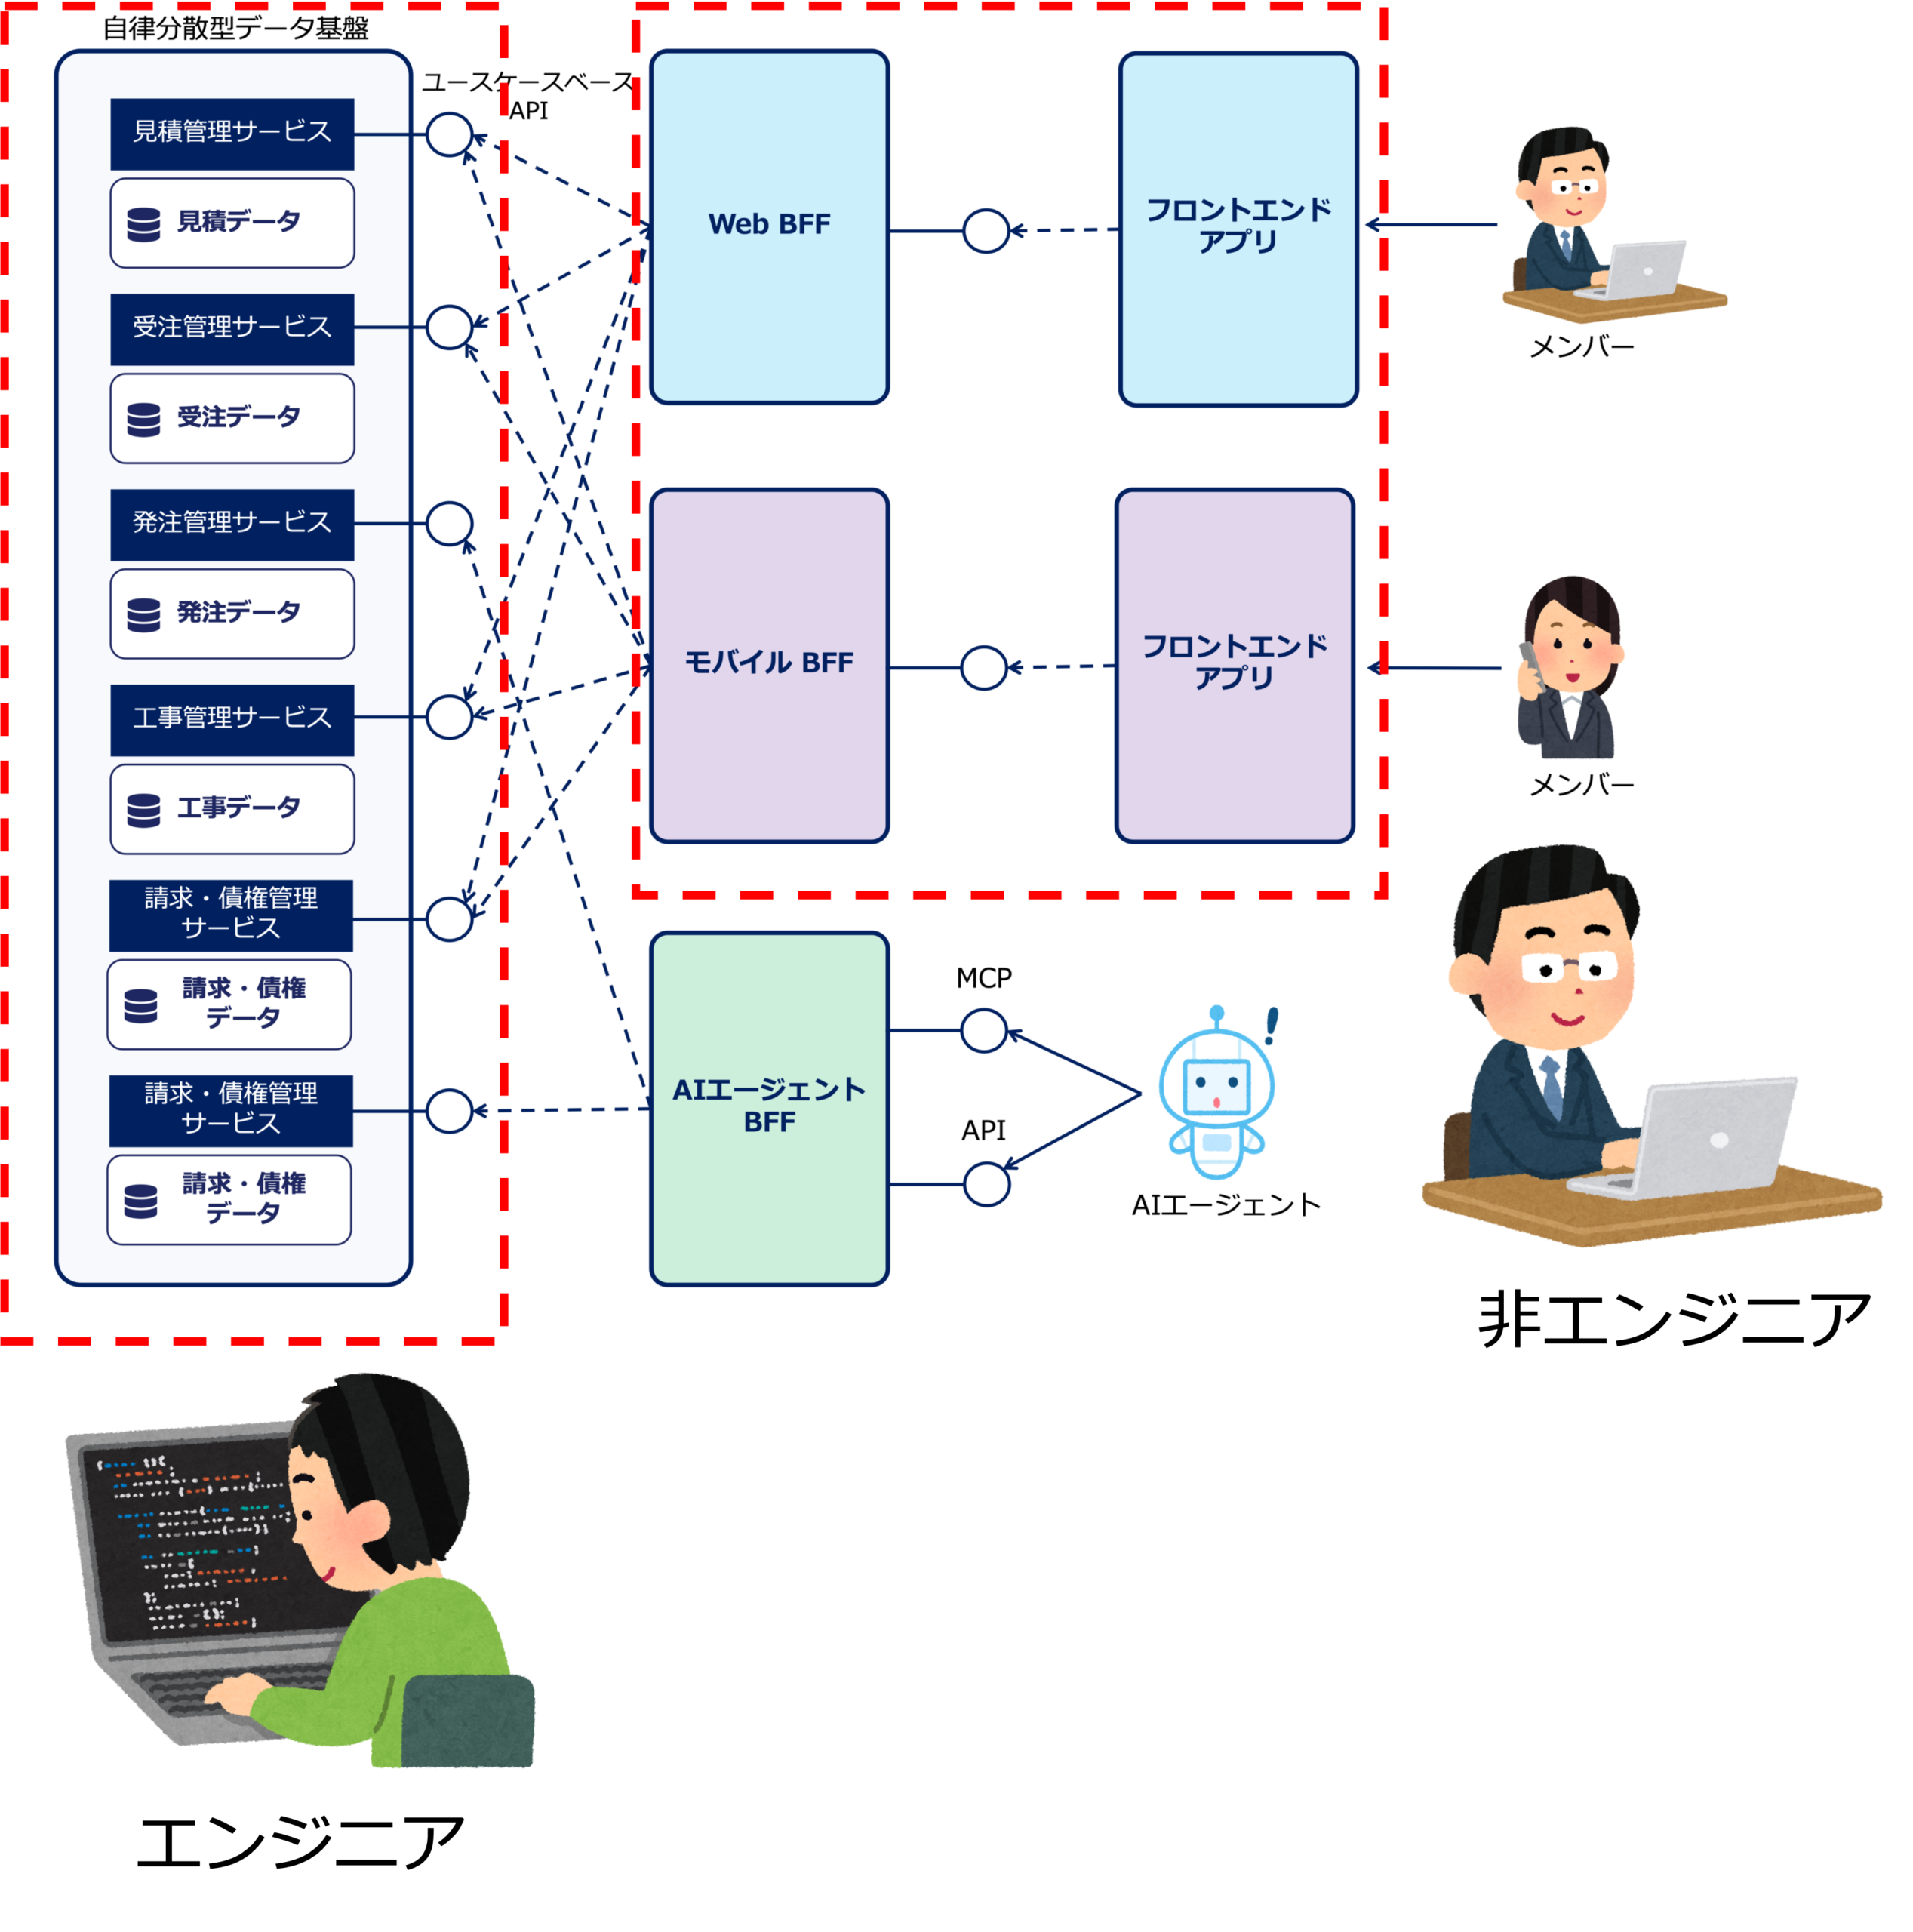
ここでは、AIエージェントを有効活用して、信頼性と安全性を求められる自律分散型データ基盤をどのように構築すればよいか説明します。